

如果模型算不对大数乘法,常规做法是给它一个计算器工具。但作者 Divyansh Agrawal 选了另一条路:直接把一颗 CPU 编译进模型权重里。他的实验项目 Qwenputer 在 10 月 22 日发表,今天登上了 Hacker News 首页第一。
具体做法是拿一个现成的 Qwen3.5-4B,在它前面加 11 层,塞进去一颗 32 位 RISC-V 核心(RV32IM,加上 Zba 扩展和一个大数协处理器)。这颗 CPU 不跑在任何外部运行时里,它就跑在模型自己的前向传播过程中。
关键一招:把 Gated DeltaNet 层当内存用
Qwen3-Next 和 Qwen3.5 的注意力层里有 3/4 用的是 Gated DeltaNet,一种线性 RNN。每个注意力头都维护一个状态矩阵,delta 规则不断更新它。
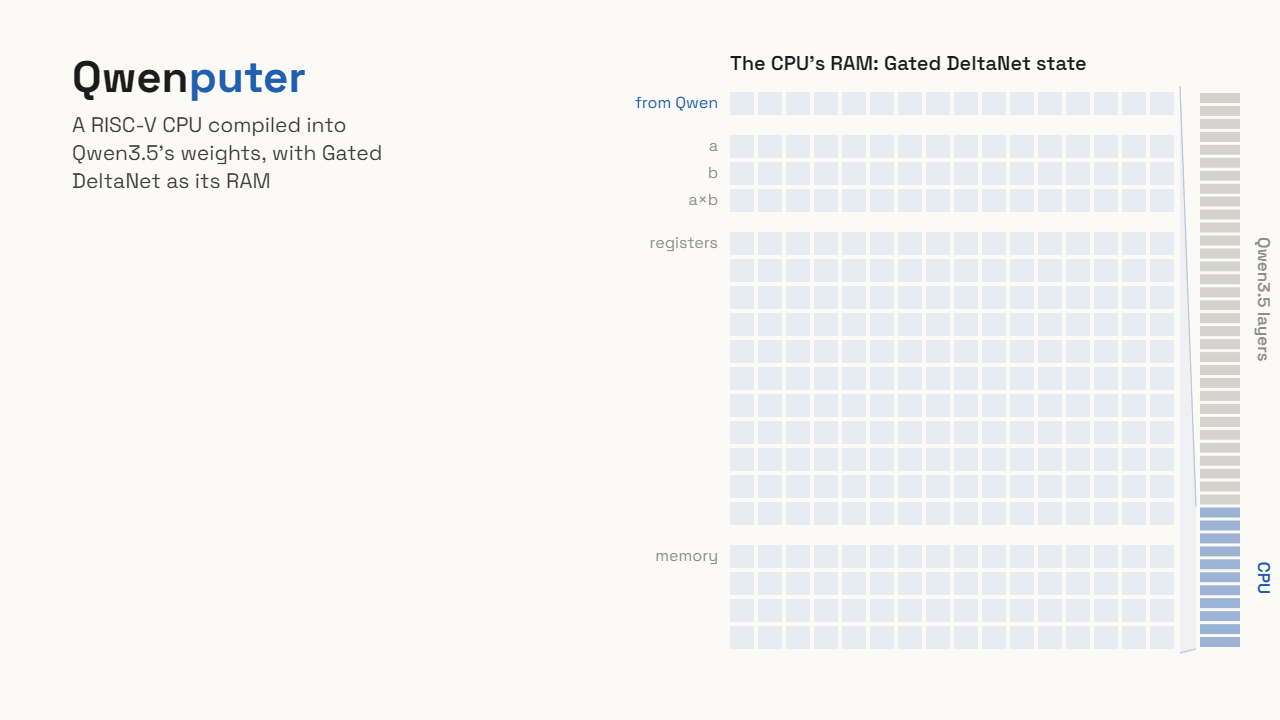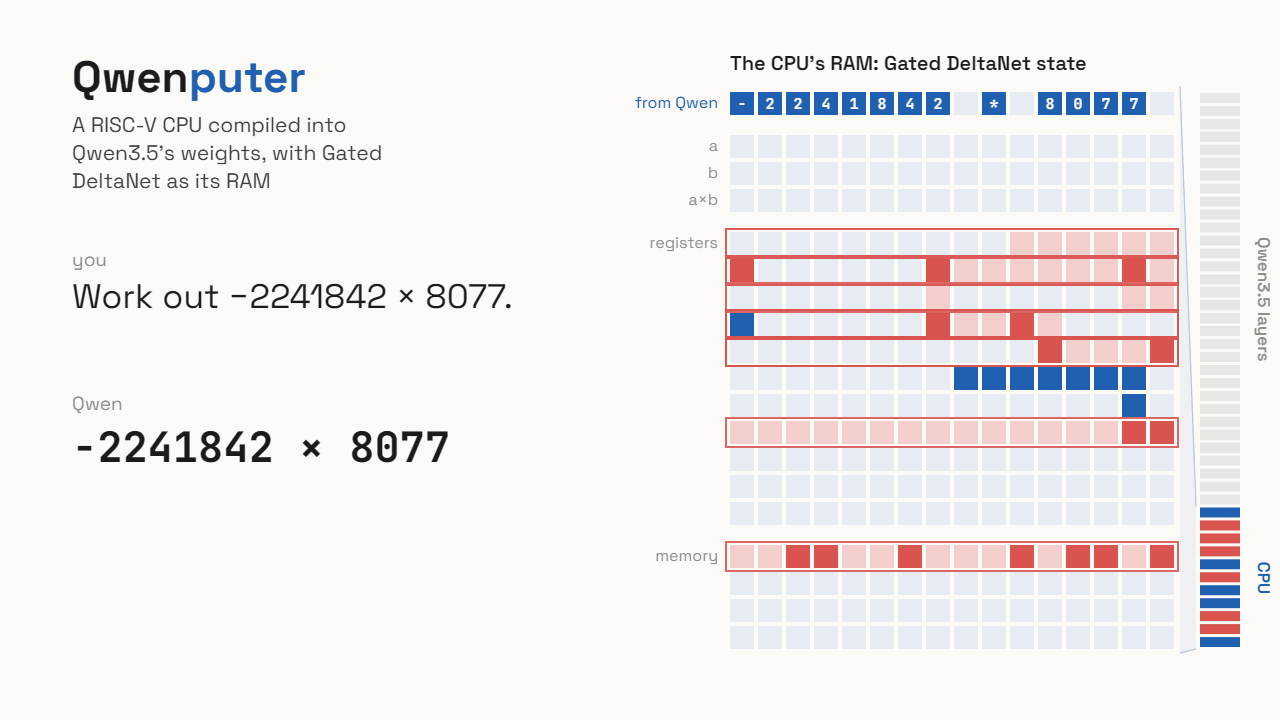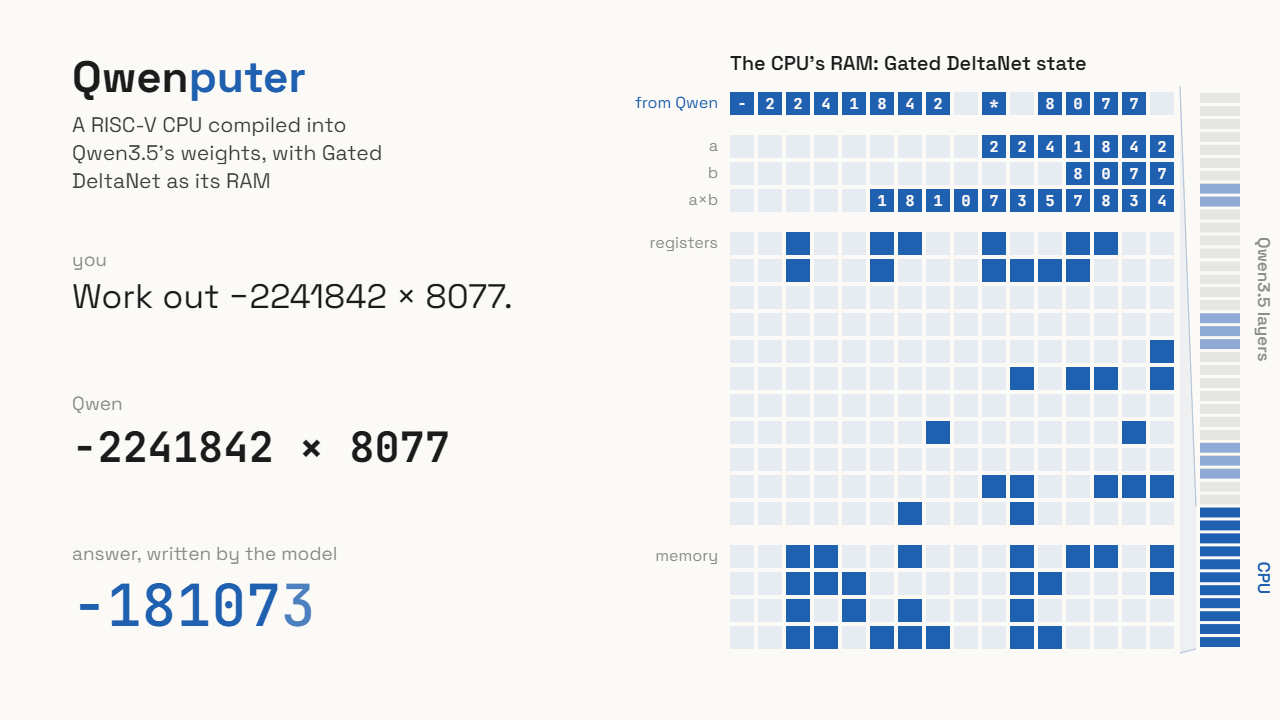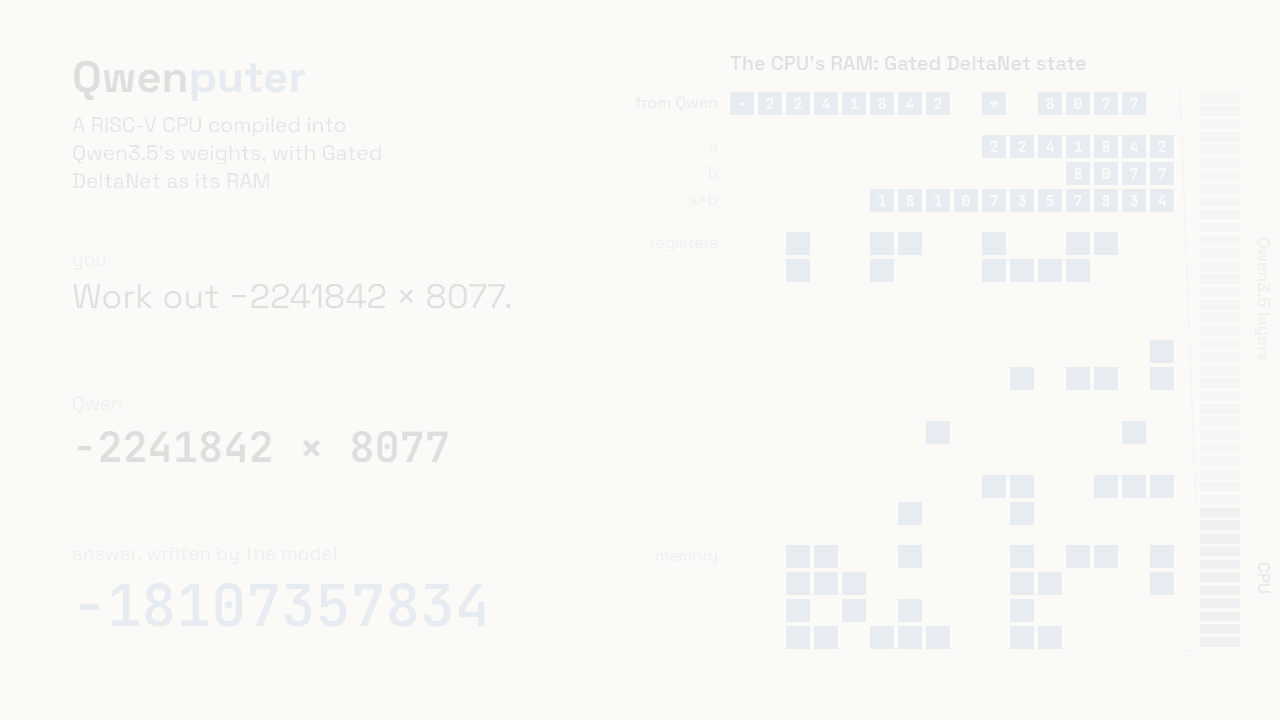
作者发现,只要把门控(gate)设为 1、写入强度(beta)设为 1,再用 one-hot 编码做键,每次写入就会精确覆盖某一行、每次查询就能精确读回一个值。也就是说,Gated DeltaNet 层本身就能当作精确、可寻址的内存用,而且成本比拿普通注意力当内存低得多——因为 GDN 头的状态大小不随对话变长而膨胀。
有了这块便宜又精确的内存,剩下的事就是编译:把 CPU 描述成一串电路步骤(读寄存器、加两个数、为零则跳转……),编译器把每一步变成 transformer 层的一部分——查表的注意力头、做算术的前馈单元、存内存的 DeltaNet 头。CPU 就这样在模型解码的过程中跑起来。
这颗 CPU 能干什么
这颗 CPU 通过了官方 riscv-tests 测试集,跑出来的程序和 qemu 对得上,还曾经连续自由运行 1800 万条指令零错误。它能跑 C 和 MicroPython 代码(有点慢),实现了完整的 RV32IM 指令集,但还不是 Linux 级别的芯片。
Qwen3.5-4B 不需要任何后训练就能用好这颗 CPU。用法很巧妙:借用模型本来就很熟悉的 tool call 格式发指令、读结果,但实际上没有发生任何外部工具调用。一个叫 RvChat 的小驱动负责把固件载入 GDN 状态,并把执行轨迹 token 挡在 Qwen 的层外面。Qwen 原来的权重完全没动,计算机的权重是叠加上去的。
实测:算术成绩直追调 Python 工具
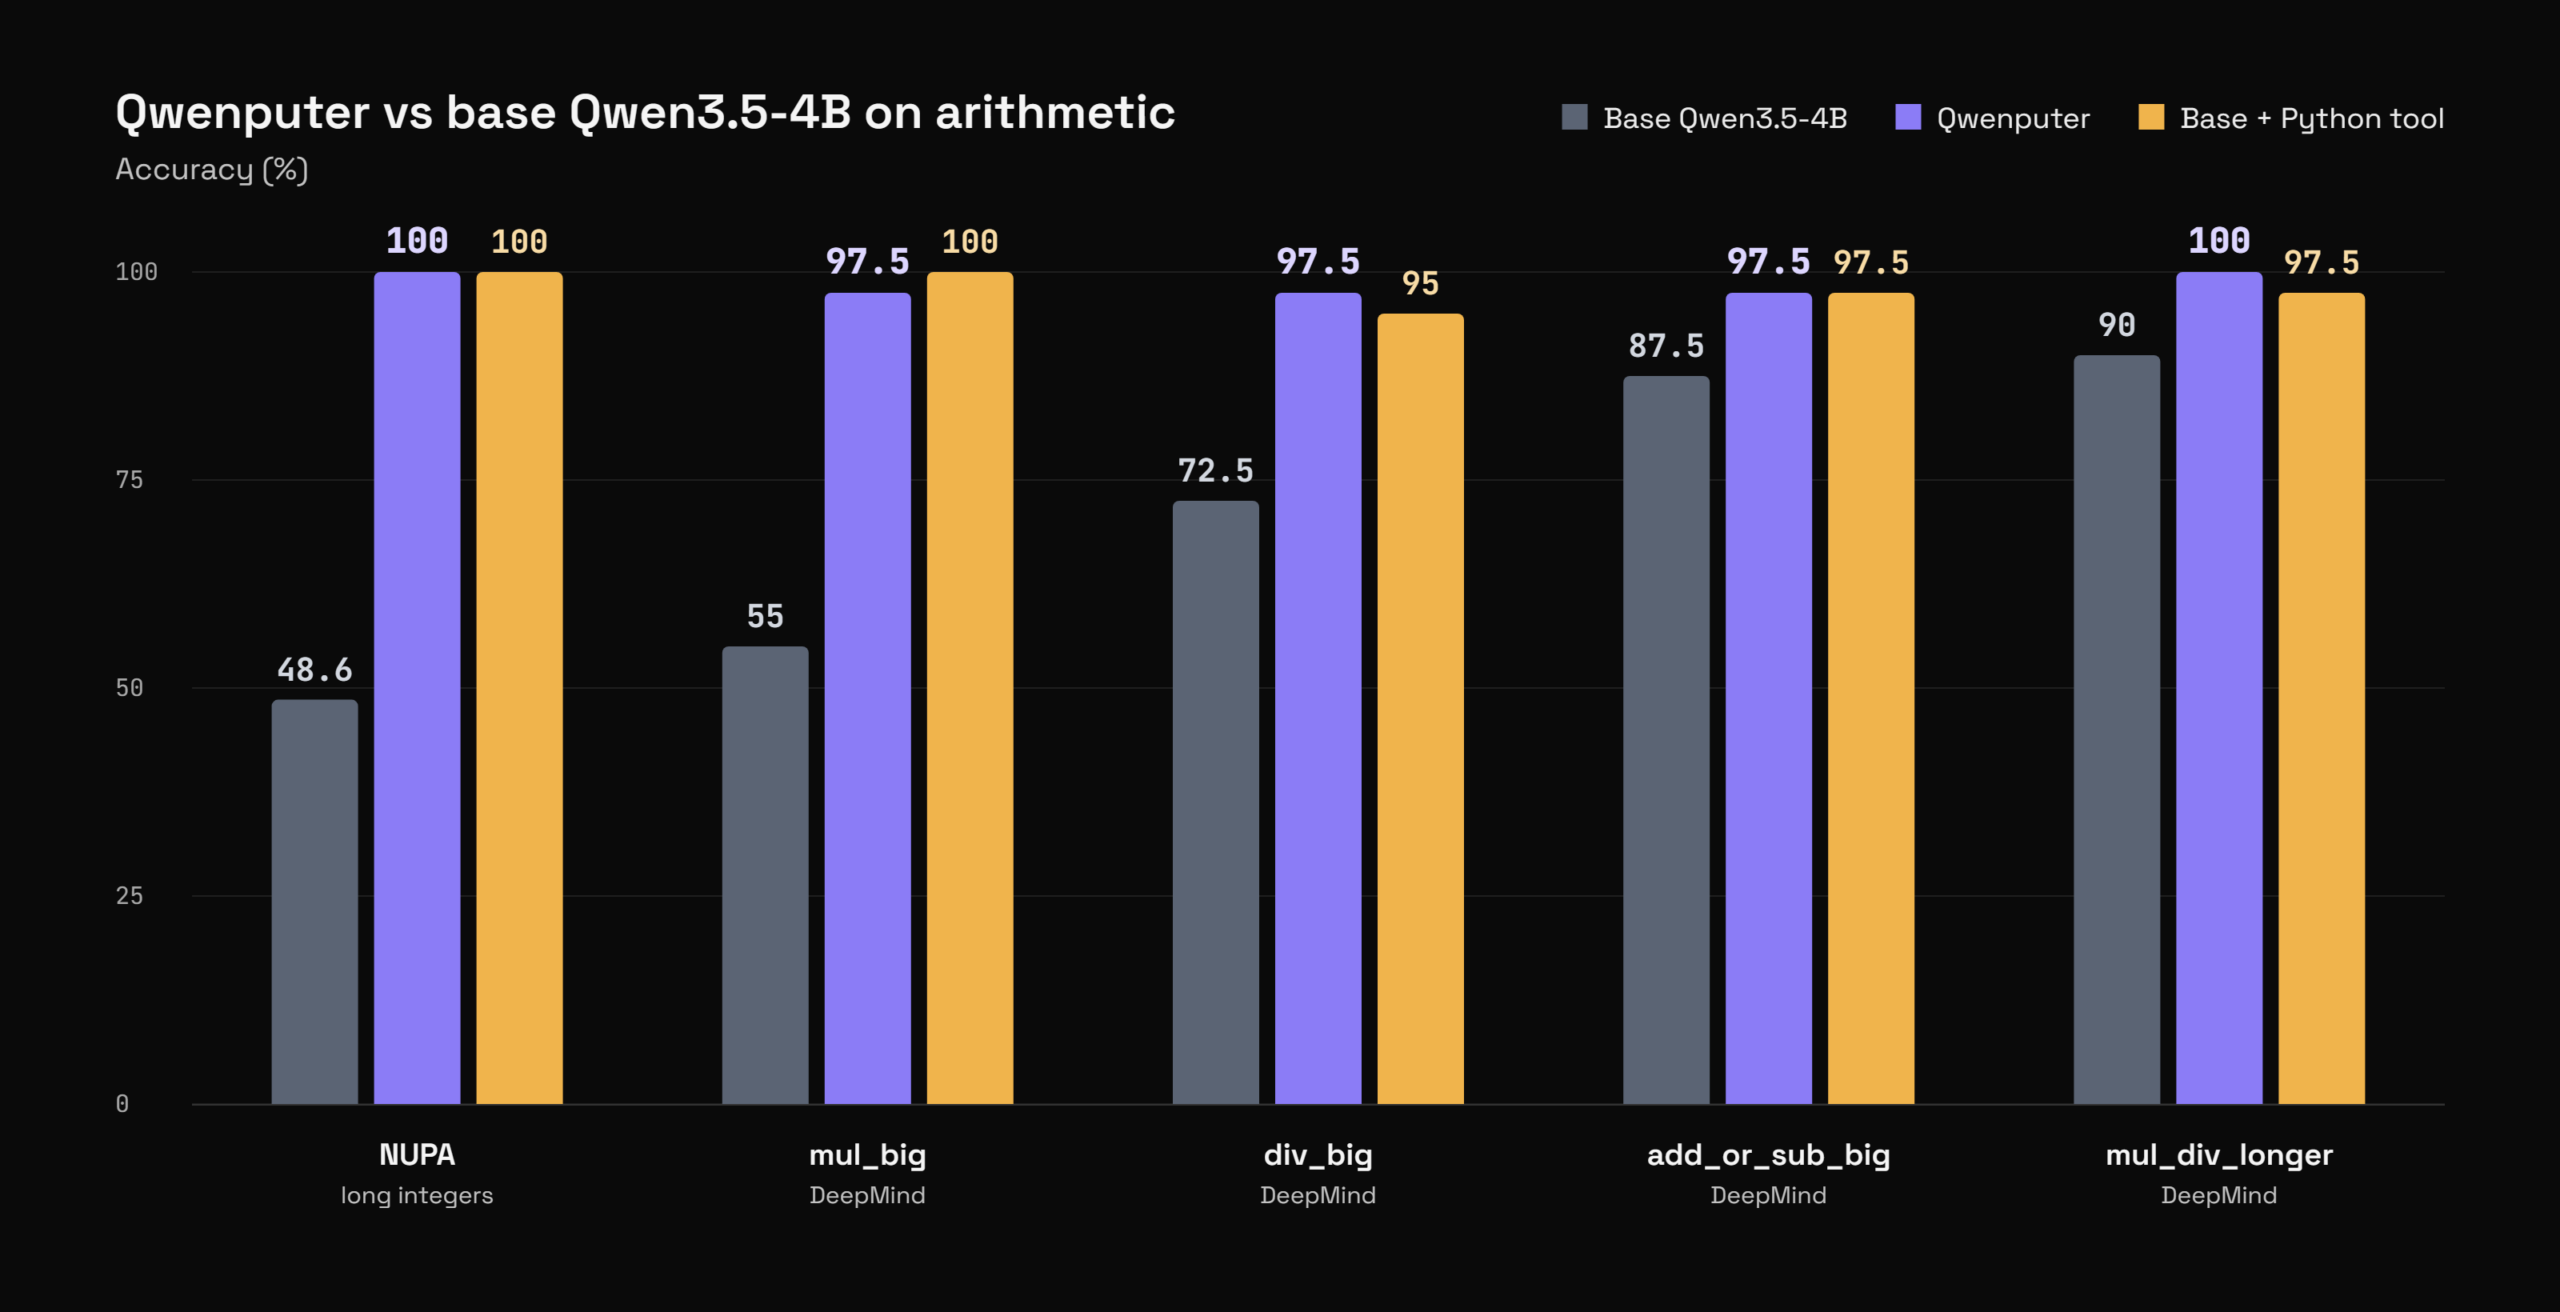
在 DeepMind 的算术测试集上:
- div_big(大数除法):Qwenputer 97.5%,给原模型调 Python 工具是 95%,原模型自己算只有 72.5%。
- mul_big(大数乘法):Qwenputer 97.5%,调 Python 工具是 100%,原模型自己算只有 55%。
- mul_div_multiple_longer:Qwenputer 100%,调工具 97.5%,原模型 90%。
- add_or_sub_big:Qwenputer 97.5%,和调工具持平,原模型 87.5%。
NUPA 的长整数算术上,Qwenputer 从 48.6% 提升到 100%,和调 Python 工具持平。作者还把约 23 万个输出位置逐个拿到参考机上重放,零不匹配。而且外挂一颗计算机没有改变模型说话的方式:正常文本与原模型的差异在噪声水平内(KL 6e-4)。
顺手还给了它一个文件系统
既然 CPU 都有了,作者顺手又在模型里做了一个实验性文件系统:文件名哈希进 1024 个槽位之一,文本存在其他注意力头里,每行 8 个 token、链式存放,最多 512 个文件、约 5.3 万 token 文本。
这个文件系统还有个好处:对话结束时把状态存下来,下次对话再载入,文件还在。用它来记那些在对话之间变了的事实,Qwen 答对 90%,而把旧对话贴回去只有 30%,和用 Python 写的记忆工具(78.9%)相比也不落下风。这部分代码还在实验分支上。
局限:很大,也很慢
作者自己也说了,这就是个实验,有几处硬伤:加层加宽之后,检查点有 18.8GB,大约是原模型的两倍(不过大多是零填充);需要 RvChat 驱动来启动固件,还不能直接用普通的 generate() 调用跑;速度也慢,每条 CPU 指令要花几个解码 token,大计算得按秒算,作者用的批量执行器在 L4 显卡上大约每秒 3200 个 CPU token。
自己试试
想上手的话,一张 24GB 显存的显卡就够。装好 uv 和 Hugging Face CLI,按作者给的命令拉代码和模型就能跑:
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf --ask "Use calc: what is 123456789 * 987654321?"
模型在 Hugging Face 和 ModelScope 上都能下到,代码在 GitHub divagr18/qwenputer(629 星)。
作者还写了两篇后续:一是混合模型怎么把推理藏进 RNN 状态、躲过思维链监控,二是这种编译进权重的结构怎么做成模型自己关不掉的内置监控工具。对 AI 安全研究来说,这也是个很有意思的试验场。
同样在本地跑大模型的思路,可以看看 colibri v2.1.0:744B 开源大模型也能在家跑,以及 Liquid AI 的 LFM3:6 个 2B 级开源模型共用一个底座。
转自 Divyansh Agrawal 的博客文章《Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5》,原文链接:https://divagr.com/blog/qwenputer

暂无评论内容