

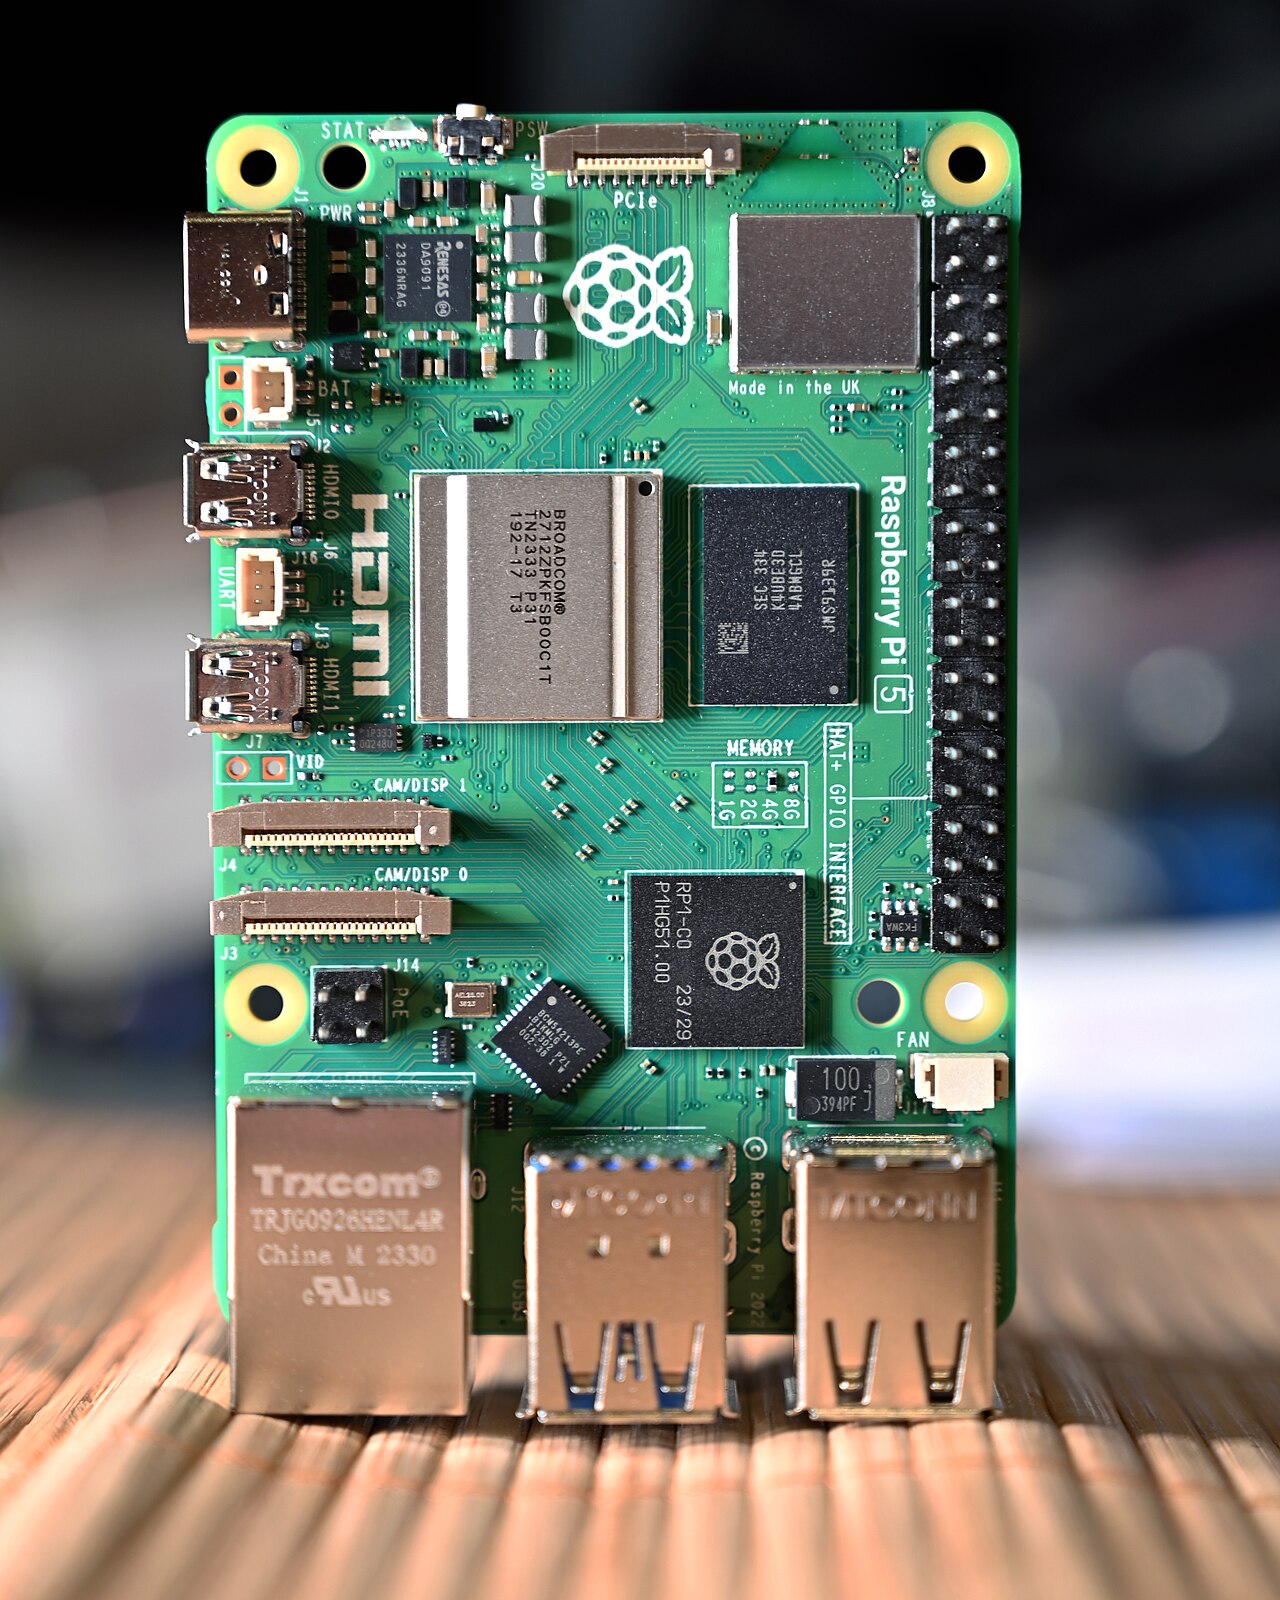
封面图为可授权替代图:Raspberry Pi 5,SimonWaldherr 拍摄,CC 署名许可,via Wikimedia Commons。原文页面无可直接转存的主图,故用此图;LFM3 的架构搜索覆盖的 14 种设备与后端组合中包括 Raspberry Pi 5。
Liquid AI 在 2026 年 10 月 27 日发布了 LFM3,新一代 Liquid Foundation Models(LFM)。首批 release 是 6 个 2B 参数量级的模型,全部从同一个 LFM3-1.7B-Base 底座分出来,覆盖文本、视觉、音频、Omni(多模态合一)与决策五类。底座与微调后的模型均为开放权重(open-weight),当天已可在 Hugging Face、Liquid AI Playground 与 Liquid AI API 上获取,文档里有本地运行与微调的说明。
定位很明确:小模型、本地跑、按任务专门化。Liquid AI 称,LFM3 比 LFM2 表达能力更强,同时保持效率;模型小到可以在单块 GPU 上微调、跑在手机、笔记本、树莓派这类设备上,成为某个专门任务上可靠的专家,而不是一个什么都行的通用大模型。
六个模型,各管一摊
| 模型 | 输入 → 输出 | 适合做什么 |
|---|---|---|
| LFM3-1.7B | 文本 → 文本 | 本地智能体与专门应用,256K token 上下文 |
| LFM3-VL-2B | 文本、图像、视频 → 文本 | 看图、看视频、空间与具身推理,机器人方向的基础 |
| LFM3-Audio-2B | 文本或音频 → 文本或语音 | 语音聊天、转写、翻译、音频理解与工具调用,支持 18 种语言 |
| LFM3-Omni-2B | 文本、图像、视频、音频 → 文本与语音 | 看、听、说的合一助手,如看着手写数学题回答语音提问 |
| d1-2B | 文本、图片 → 结构化答案 | 不写文章、直接给决定:是/否、选项、分数,带校准概率 |
| d1-Omni-2B | 文本、图片、音频 → 结构化答案 | 语音输入的同样决策,语音提问时几乎保持书面提问的准确率 |
不用一个大通用模型包打天下,而是按输入模态与输出形式挑一个、再微调,这是整套 family 的用法。两个决策模型是新形态:给它一个场景(工单、发票、应用截图、照片、语音留言)加一串问题,它在一次前向 pass 里全部回答,每个答案带概率;新加的 typed answers 还能画框定位、抽取文本数字日期、给估计值与范围、多选。
新架构:三混层 + 22T token 预训练
LFM3 仍是混合架构:门控短卷积 + 滑动窗口注意力 + 全局注意力。24 层里 13 层是卷积(卷积核从 LFM2 的 3 加到 7)、5 层是 256 token 窗口的滑动窗口注意力、6 层是全局注意力;另有逐头门控注意力、部分 RoPE 与 sandwich norm 等改动。底座在 22T token 上预训练,最后 3.5T token 是精选高质量数据的中期训练,智能体轨迹与多样化工具调用占比更大,上下文窗口也由此扩展到 256K token。词表与 LFM2.5-8B-A1B 相同,为 128K,对非拉丁文字的分词更高效。
架构搜索的硬件范围从 LFM2 的一部手机加一台笔记本,扩大到 14 种设备与后端组合:三星 Galaxy S26 Ultra 与 OnePlus 15 手机、Raspberry Pi 5、Apple M4 Max 与 AMD Ryzen AI 笔记本、Arm 与 x86 云 CPU、GPU 与高通 Hexagon NPU。Liquid AI 称,在 8K token 上下文时,LFM3-1.7B 按参数算比 LFM2-1.2B 快约 25%。
文本模型:小个子,智能体任务上不输大块头
官方博客列出的基准成绩均为 Liquid AI 自测、尚未经独立验证,读的时候按厂商数据看。LFM3-1.7B 在智能体与工具调用类基准上与数倍于它的模型相当:在 BFCL V4(71.39)、ToolSandbox(80.36)上领先同表对比模型;在 WebArena-Verified(38.42)与 AutomationBench(41.29)上超过 Qwen3.5-9B;指令遵循 IFEval 96.66、IFBench 73.03 也是同表最高。但在大模型占优的智能体编程与知识类基准上它仍落后,Liquid AI 自己也写明,搜索能缩小知识差距——接搜索后 Humanity’s Last Exam 得分接近翻倍。
训练后处理分四阶段:1.75T token 的监督微调、跨数学/代码/SQL/结构化输出的多域混合强化学习(带长度惩罚、保持回答简洁)、六个 specialist RL 教师的多域 on-policy 蒸馏、以及在真实智能体 harness 里跑网页浏览与办公任务的 agentic RL。文本模型已针对 Hermes Agent、Pi、OpenClaw 等 harness 做 post-training:可以分拣收件箱、管理日历、网上调研、发 WhatsApp 晨间简报、在数千个工具里用工具搜索找对工具。
设备端表现(llama.cpp、Q4_0、32K 上下文):LFM3-1.7B 在三台被测设备上解码最快,是次快模型的 1.8 到 2.8 倍,内存占用最低;128K 满上下文的 KV cache 只要 1.6 GB,对比 Qwen3.5-4B 的 4.3 GB 与 MiniCPM5-2B 的 5.6 GB。单块 NVIDIA B300 + SGLang BF16 时,每天可产 36 亿 token(1024 并发请求)。Liquid AI 还用 30 多万个 LFM3-1.7B 智能体并行调查了 Enron 邮件档案,作为吞吐量的演示。
视觉、音频与 Omni:都能在设备上跑
视觉模型 LFM3-VL-2B 首次接受视频输入,能对录播课、手机拍的 walkthrough、摄像头片段提问;会逐步推理再回答;能定位物体、推理空间关系。62 项视觉基准平均 71.4 分,官方称领先同尺寸模型至少 7.4 分,与大 6 倍多的 Gemma 4 12B 持平、超过 Gemini 3.5 Flash Lite、距 GPT-5.6 Luna 不到 2 分。新自研视觉编码器比上一代 SigLIP2 编码器少用 3 倍算力;视频编码把每对采样帧联合嵌为一个时间切片,序列长度减半。
音频模型 LFM3-Audio-2B 用自研音频编码器与 LiquidCodec:语音聊天可边说边回(首 token 低至 50ms)、18 种语言的转写/合成/翻译、理解录音里的语音与事件、把语音请求转成工具调用。语音合成在单 CPU 线程上约 87 倍实时。
Omni 模型 LFM3-Omni-2B(2.2B 参数)是 Liquid AI 的第一个 omni 模型:能对着图片用语音提问并以文本或语音作答,能同时处理视频画面与同步音频做推理,能把视觉上下文与语音指令结合生成结构化工具调用。官方举例:看手写数学题的家教、拿着走、边看边问的平板、结合摄像头画面与司机语音的车载助手。
两个专门化例子:微调几小时,就能当行家
官方演示了把 LFM3-VL-2B 专门化的两条路。风电叶片巡检:用约 3000 张公开照片(WTBs2025),SFT + GRPO 微调几小时、在一块 A100 上完成;约 1400 张留出照片上,缺陷分类准确率从开箱不到 10% 升到 67%,检测 F1 从 0.003 升到 0.11(对比 GPT-6 Luna 的 0.01)。机器人:把同一模型微调成机械臂操作器,用 rank-32 LoRA、约 4 万样本、单块 AMD Instinct MI325X 上约 6 个 GPU 小时,无需改架构;再配一个微调过的 d1-2B 做 skill monitor。
许可与获取:开放权重,但大公司商用要另谈
模型以 LFM Open License v1.0 发布。据 Unite.AI 与 dev.to 对发布信息的整理,年收入低于 1000 万美元的商业使用免费,达到或超过该门槛的公司需与 Liquid AI 另签商业协议——写进计划前请以模型卡与许可原文为准。首日启动伙伴包括 Ambarella、AMD、Arm、Intel(OpenVINO)、NVIDIA、OpenRouter、高通(Qualcomm AI Hub 与 GenieX)与 Vercel,梅赛德斯-奔驰与 Shopify 参与了发布前测试评估;运行时支持 llama.cpp、MLX、vLLM、Ollama、LM Studio、Unsloth 与 SGLang 等。
相关阅读:同样主打本机运行的离线 AI 套件,可看站内《Off Grid AI:开源离线 AI 套件,手机和 Mac 上聊天、生图、识图全在本地跑》;本地语音方向可看《VoiceStudio:开源本地版 ElevenLabs,8.9 万星,646 种语言全在自己电脑上跑》。基准数字均为官方发布数据,未经独立验证,选型前建议按自己的任务实测。
转自 Liquid AI 官方博客的文章《Introducing LFM3: Every Modality for Specialized Intelligence》,原文链接:https://www.liquid.ai/blog/lfm3


暂无评论内容