

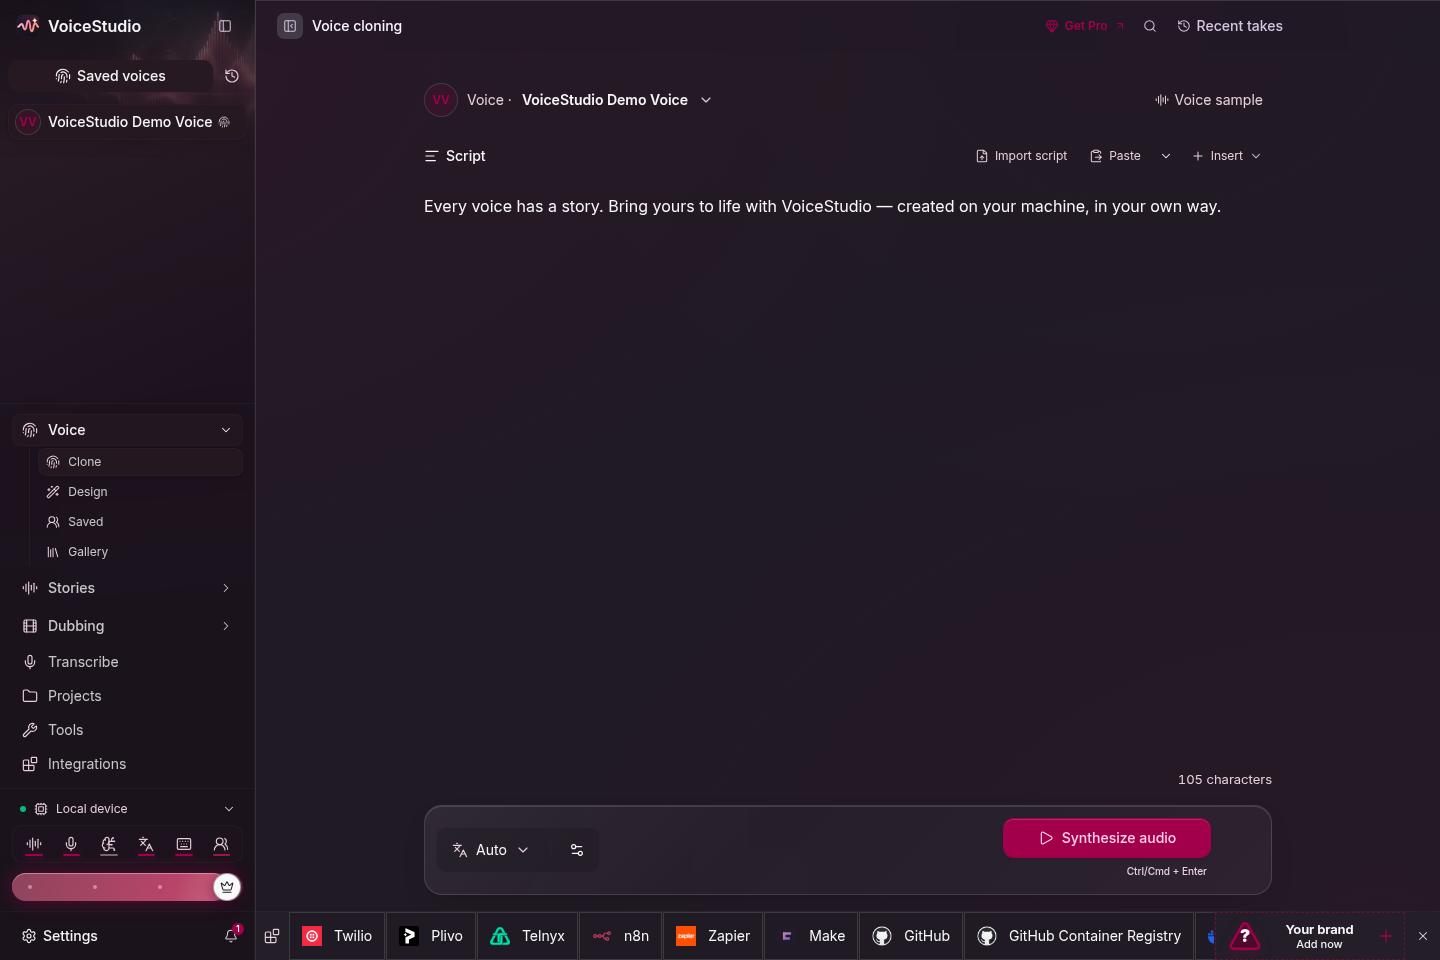
还在为配音、播客、有声书按分钟付云端费用吗?开源项目 VoiceStudio 把整套语音工作流搬到了你自己的电脑上:克隆声音、设计声音、给视频配音、听写、转录、做有声书,官方称支持 646 种语言,而且全程本地运行。项目在 GitHub 上已经拿到 89,395 星(截至本文核对时),10 月 27 日当天仍在 GitHub Trending 上快速涨星。
它能干什么
按仓库 README 的划分,VoiceStudio 分三组能力:
- 创作:上传一段干净的参考录音克隆声音,或用文字描述设计一个新声音;还有悬浮窗听写。
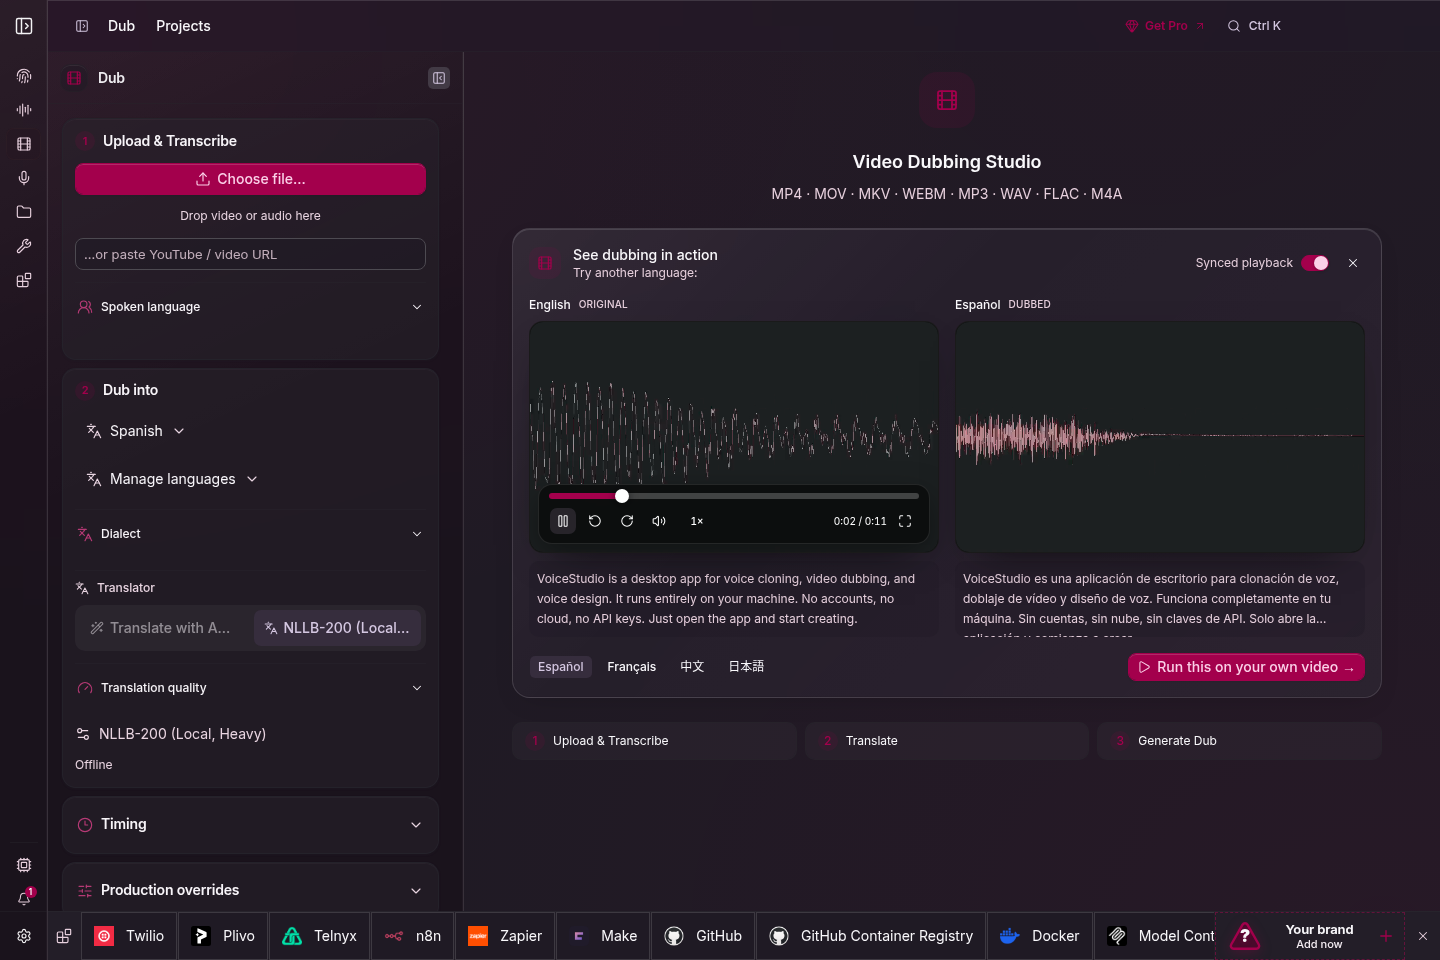
- 生产:给视频配带时间轴的旁白,做故事、有声书和批量任务,转录音频。
- 连接:本地 API 与 MCP 服务器,让 Claude Code、Codex、Cursor 这类智能体直接调用它生成旁白或转录文件,音频不用出本机。
默认引擎是 k2-fsa 的 OmniVoice,也可以在模型管理器里切换其他引擎。项目方自己的隐私表述是:本地工作流跑在你的硬件上,远程服务是可选的,使用分析需要你同意。
Mac 上怎么跑
macOS 与 Linux 一条命令安装(官网提供安装脚本,另有 macOS .dmg、Windows .exe、Linux .AppImage/.deb,以及 Android/iPhone 预览版):
curl -fsSL https://voicestudio.sh/install | sh
硬件方面,Apple Silicon(M1–M5)走 Metal(MPS)加速;Windows/Linux 的 NVIDIA 显卡走 CUDA;没有独显也能用 CPU 跑,只是更慢,安装时会装一个约 5GB 的 CPU 版 PyTorch。注意:Intel Mac 只能跑应用界面,需要连远程后端,这点买之前先确认。
上手路径也很简单:打开“语音克隆”,选一个声音或上传参考录音,输入文字,生成;模型会在提示时安装。会用智能体的用户还可以直接给智能体贴一段提示词,让它按仓库里的 agent 安装指南装好并做一次测试生成,支持 Skills 的智能体可运行 npx skills add debpalash/VoiceStudio。
先提醒两件事
第一,授权。应用本身是 AGPL-3.0 开源,但模型权重、声音与生成结果另有各自的条件;README 也明确写了“仅在获得许可的情况下克隆声音”,不要拿别人的声音做克隆。
第二,别把它当成 ElevenLabs 的一键平替。它的价值是“把一堆本地语音模型 glue 在一起”:省去了你自己配 PyTorch、切长文本、拼音频的麻烦,但模型下载、显存占用和不同引擎的质量差异仍然存在,CPU 机器上要对速度有合理预期。
如果你平时已经在用本地语音工具,可以对照着看本站之前介绍的开源语音输入 Voltip(按住说话、松开出整理好的文字,可纯本地识别),以及免费开源剪辑工具 Concat(AI 字幕、配音、无水印,同样内置 MCP)。三者拼起来,就是一条不依赖云端按量计费的本地音视频工作流。
转自 GitHub 仓库 debpalash/VoiceStudio 的 README,原文链接:https://github.com/debpalash/VoiceStudio


暂无评论内容