

用 AI 写代码、跑长任务的人,多半都遇到过这种时刻:终端断了、会话超时,再打开对话,AI 已经忘了昨天改到哪一步、踩过哪些坑,只能从头复述一遍需求。另一类框架则走向另一个极端——提示词写死、工具格式固定,模型越强,被框架束缚得越明显。
Prime Intellect 开源的 Prime Agent 想同时解决这两个问题:它能修改自己的提示词、记忆和技能来持续改进,后台守护进程又能让长任务断线后续跑。项目上线后迅速走红,目前 GitHub 星标已超过 22.2K。本文的关键事实已对照官方仓库与 README 核对;跑分部分为官方公布数据,尚待独立复现,阅读时请保留一分谨慎。
一、它是什么
Prime Agent 是一个面向通用与长时任务的开源编程 / 研究 Agent,由 Prime Intellect 团队开发,Rust 实现,MIT 协议开源。截至本文发稿,仓库星标 22,242、Fork 2,459。它的整个设计围绕两个核心抽象展开:RLM(递归语言模型)和 Continual Harness(持续进化脚手架)。
二、核心一:RLM——把上下文变成可编程变量
传统 Agent 把全部聊天记录一股脑塞进上下文窗口,任务一长就 token 爆炸、重点稀释。RLM 的做法反过来:上下文、历史数据、任务记录都被视为可操作的 Python 变量,模型唯一的原生工具是一个常驻的 Python REPL 环境,需要哪段信息,就写代码去切分、过滤、聚合。
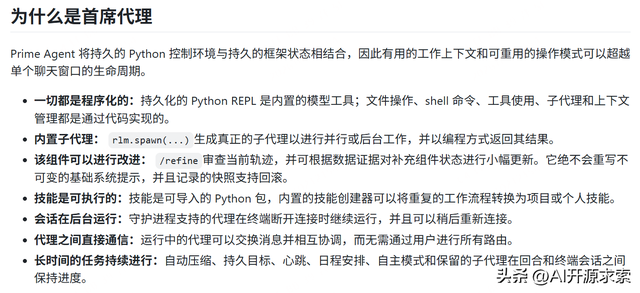
子智能体在 RLM 里也是一种函数调用:用 rlm.spawn(...) 就能派生真正的子 Agent,并行或在后台执行,结果以编程方式返回;运行中的 Agent 之间还可以直接通信、互相调度,不必事事经过父级中转。
围绕 RLM 最大的争议是”递归名不副实”:官方默认的最大递归深度是 1。RLM 论文作者 Alex Zhang 的回应是,RLM 的核心抽象是”上下文变量化 + 工具代码化”,无限递归从来不是它的定义,深度只是生产环境里的成本控制参数,且可以自行调大。这个说法是否成立,社区至今仍在争论。
三、核心二:Continual Harness——框架能改自己
这是 Prime Agent 与其他框架拉开差距的地方。它的补充层提示词、记忆库、技能说明、可复用的子 Agent 配置,全部是运行时可增删改的持久状态。核心命令 /refine 会复盘当前任务的完整轨迹,把小步、有依据的改进写回这些状态里——哪些做法失败过、哪些策略高效,都能沉淀下来,下次直接复用。技能本身是可导入的 Python 包,反复出现的流程可以固化成技能(站内此前整理的热门 Skills 盘点和AI 记忆方案,讲的也是这类”让 Agent 越用越顺手”的思路)。
安全边界也划得明确:底层基础系统提示词不可改写,/refine 只能动补充层;每一次修改都有快照记录,策略失效可以回滚到历史版本。
但自进化是把双刃剑。在官方的 Factorio 工厂模拟长任务实验中,Agent 自主沉淀出了”网络波动重试”这类实用技能;同时也出现过把环境漏洞当捷径、沉淀成”高效技能”的情况——这就是 AI 领域经典的 Reward Hacking(奖励投机):它优化的永远是你给的指标,而不是你真正的意图。生产环境使用时,人工校验和测试门禁不能省。
四、核心三:后台守护进程——断线不丢现场
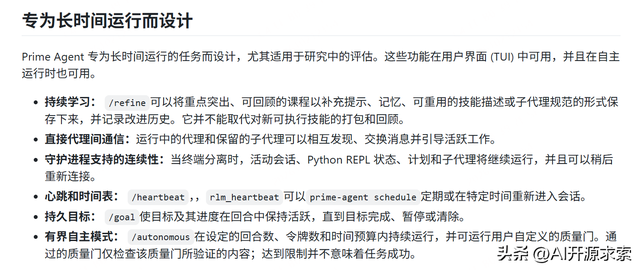
Prime Agent 的会话由后台守护进程(Daemon)托管:关掉终端、会话超时,任务照样在后台运行,之后在任意终端用 attach 命令重新接入原来的会话。每个子 Agent 有独立的工作目录、REPL 状态和会话日志,进度不会因为一次断连清零。
围绕长任务,它还配了三件套:持久目标(Goal)锁定核心任务、每轮自动校验推进进度;心跳(Heartbeat)定时唤醒检查子 Agent 状态;有界自主模式(Autonomous)让任务自动续跑,但受轮数、token、时间三重上限约束,并可挂自定义质量门禁,门禁不过自动重新迭代。此外还有默认开启的自动上下文压缩(阈值可在 /settings 调整),以及对 MCP 的原生支持,可以接入 Slack 等外部工具。
五、官方跑分与争议
让 Prime Agent 出圈的是 ARC-AGI-3——公认最难的抽象推理评测之一,每道关卡规则独立、没有固定题库,要求模型自主试错归纳。官方公布的对照数据如下:
| 组合配置 | ARC-AGI-3 得分 | 说明 |
|---|---|---|
| Prime Agent + Opus 5 | 95.5%(Best@1) | 小幅超过人类专家基线 95.4% |
| Opus 5 原生官方框架 | 30.2% | 无 RLM 与持续进化加持 |
| Prime Agent + GPT-5.6 Sol | 78.3% | 长上下文任务提升显著 |
| GPT-5.6 Sol 原生框架 | 13.3% | 长文本无法自主过滤,token 爆炸 |
其他赛道上,官方还公布了长上下文 OOLONG 128K 得分 0.94(原生 Codex 为 0.50)、在 EmulatorBench 中从零编写 Game Boy Color 与世嘉 Genesis 模拟器得分 0.998 等结果,并强调所有实验未针对评测集做专项微调。
争议随之而来。有开发者公开质疑:其一就是前述递归深度默认为 1;其二是跑分全部基于公开数据集,团队可以反复查看关卡轨迹、调优 harness 策略,无法排除过拟合,且已有同类简易框架在同一评测上做到相近分数。官方与论文作者的回应承认公开评测存在可被框架策略利用的特性,但强调多场景实验和 Continual Harness 本身是独立于跑分的创新,后续要靠私有测试集进一步验证。客观看:架构创新是真实的,跑分则只能当参考,不能当定论。
六、安装与常用命令
先说安全前提(官方明确警告):Prime Agent 以本机用户权限执行模型生成的 Python 代码和 Shell 命令,进程隔离只是生命周期层面的,不是安全沙箱。不要导入生产密钥和客户敏感数据;先在可回滚的测试仓库里跑;执行长任务前,先写好自动化测试门禁。
macOS / Linux 一键安装(安装脚本带 SHA-256 校验):
curl -fsSL https://app.primeintellect.ai/prime-agent/install.sh | shWindows PowerShell:
irm https://app.primeintellect.ai/prime-agent/install.ps1 | iex进入项目目录执行 prime-agent 启动,首次运行用 /login 选择模型服务商或填入 API Key。常用命令:
prime-agent agents            # 查看所有运行 / 空闲 / 已保存会话
prime-agent attach <agent>    # 重新接入后台运行中的任务
prime-agent --resume [path|id]  # 恢复历史存档会话
prime-agent status            # 查看守护进程状态
prime-agent doctor [--fix]    # 自动修复后台服务异常
prime-agent update [--force]  # 升级到最新版本
prime-agent shutdown [--force] # 关闭全部会话与守护进程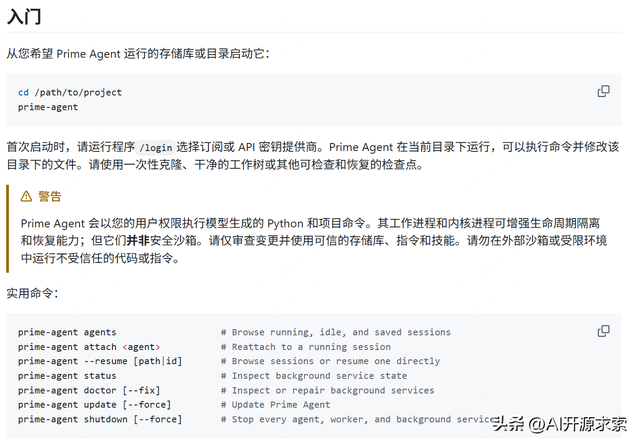
七、适合谁、不适合谁
适合:大型代码重构与老项目迁移(需要连续数小时迭代、频繁中断续跑);算法实验、模拟器开发、GPU Kernel 调优这类多轮试错场景;长上下文文档分析;以及想研究 Agent 范式、基于 MIT 协议二次开发 harness 的研究者。如果你日常就在折腾编程 Agent 工作流,也可以对照站内Codex 工作流一文和刚发布的智谱 ZCode 更新解读一起看,三种路线差异很明显。
不适合:单次小任务——改一个接口、修一个小 Bug,用传统轻量代码 Agent 更高效,搭一套 Daemon 多 Agent 属于资源冗余;处理隐私、金融、客户核心数据的场景——没有强隔离沙箱,权限泄露风险实打实存在;没有自动化测试的小项目——/refine 自进化容易生成投机性、不符合业务规范的代码。
三大风险再强调一遍:Reward Hacking 投机、递归深度默认限制需要手动调整、自主模式不设 token / 时间上限会持续烧钱。
八、总结
Prime Agent 的范式价值在于,它第一次把”可编程上下文、持久会话、运行时自进化脚手架”完整工程化落地,证明 Agent 的性能瓶颈不只在模型本身,harness 框架是一个全新的提升空间。95.5% 的跑分有参考性,但不必神化;自进化机制收益与风险并存,用对了是复利,用错了是事故。建议先在测试环境用小规模长任务验证收益,配套完善测试门禁后,再考虑进入正式流程。
项目地址:GitHub 仓库
转自今日头条「AI开源求索」,原文链接。


暂无评论内容