
百度在 11 月 5 日放出了 ERNIE 5.5 Flash Base 的权重:280B 总参数的稀疏 MoE 模型,每 token 只激活 14B,从头预训练 33.5T token,训练上下文 128K、微调与推理可扩到 1M token。权重在 Hugging Face 与 ModelScope 同步上架,有 FP8 与 BF16 两个版本,SGLang 与 vLLM 的部署文档也一并给了。
要注意的是,这次放出的是预训练终点的 Base 检查点,没有经过 mid-training 与 post-training:它不是开箱即用的聊天模型,而是给开发者做领域适配、指令微调与强化学习的地基。架构上它下了不少功夫:43 层(1 层 dense FFN + 42 层 Multi-Router Latent MoE),每层 512 个路由专家取 top-10、另加 1 个共享专家;注意力是 37 层重度压缩注意力(HCA)与 6 层 MLA-DSA 的混合,外加 VHA、ECHO、mHC 超连接与 MultiMax 输出头,目标都是把激活算力、KV 缓存与长上下文成本一起压下来。FP8 权重约 280GB、BF16 约 560GB,跑起来仍是多卡服务器的活。
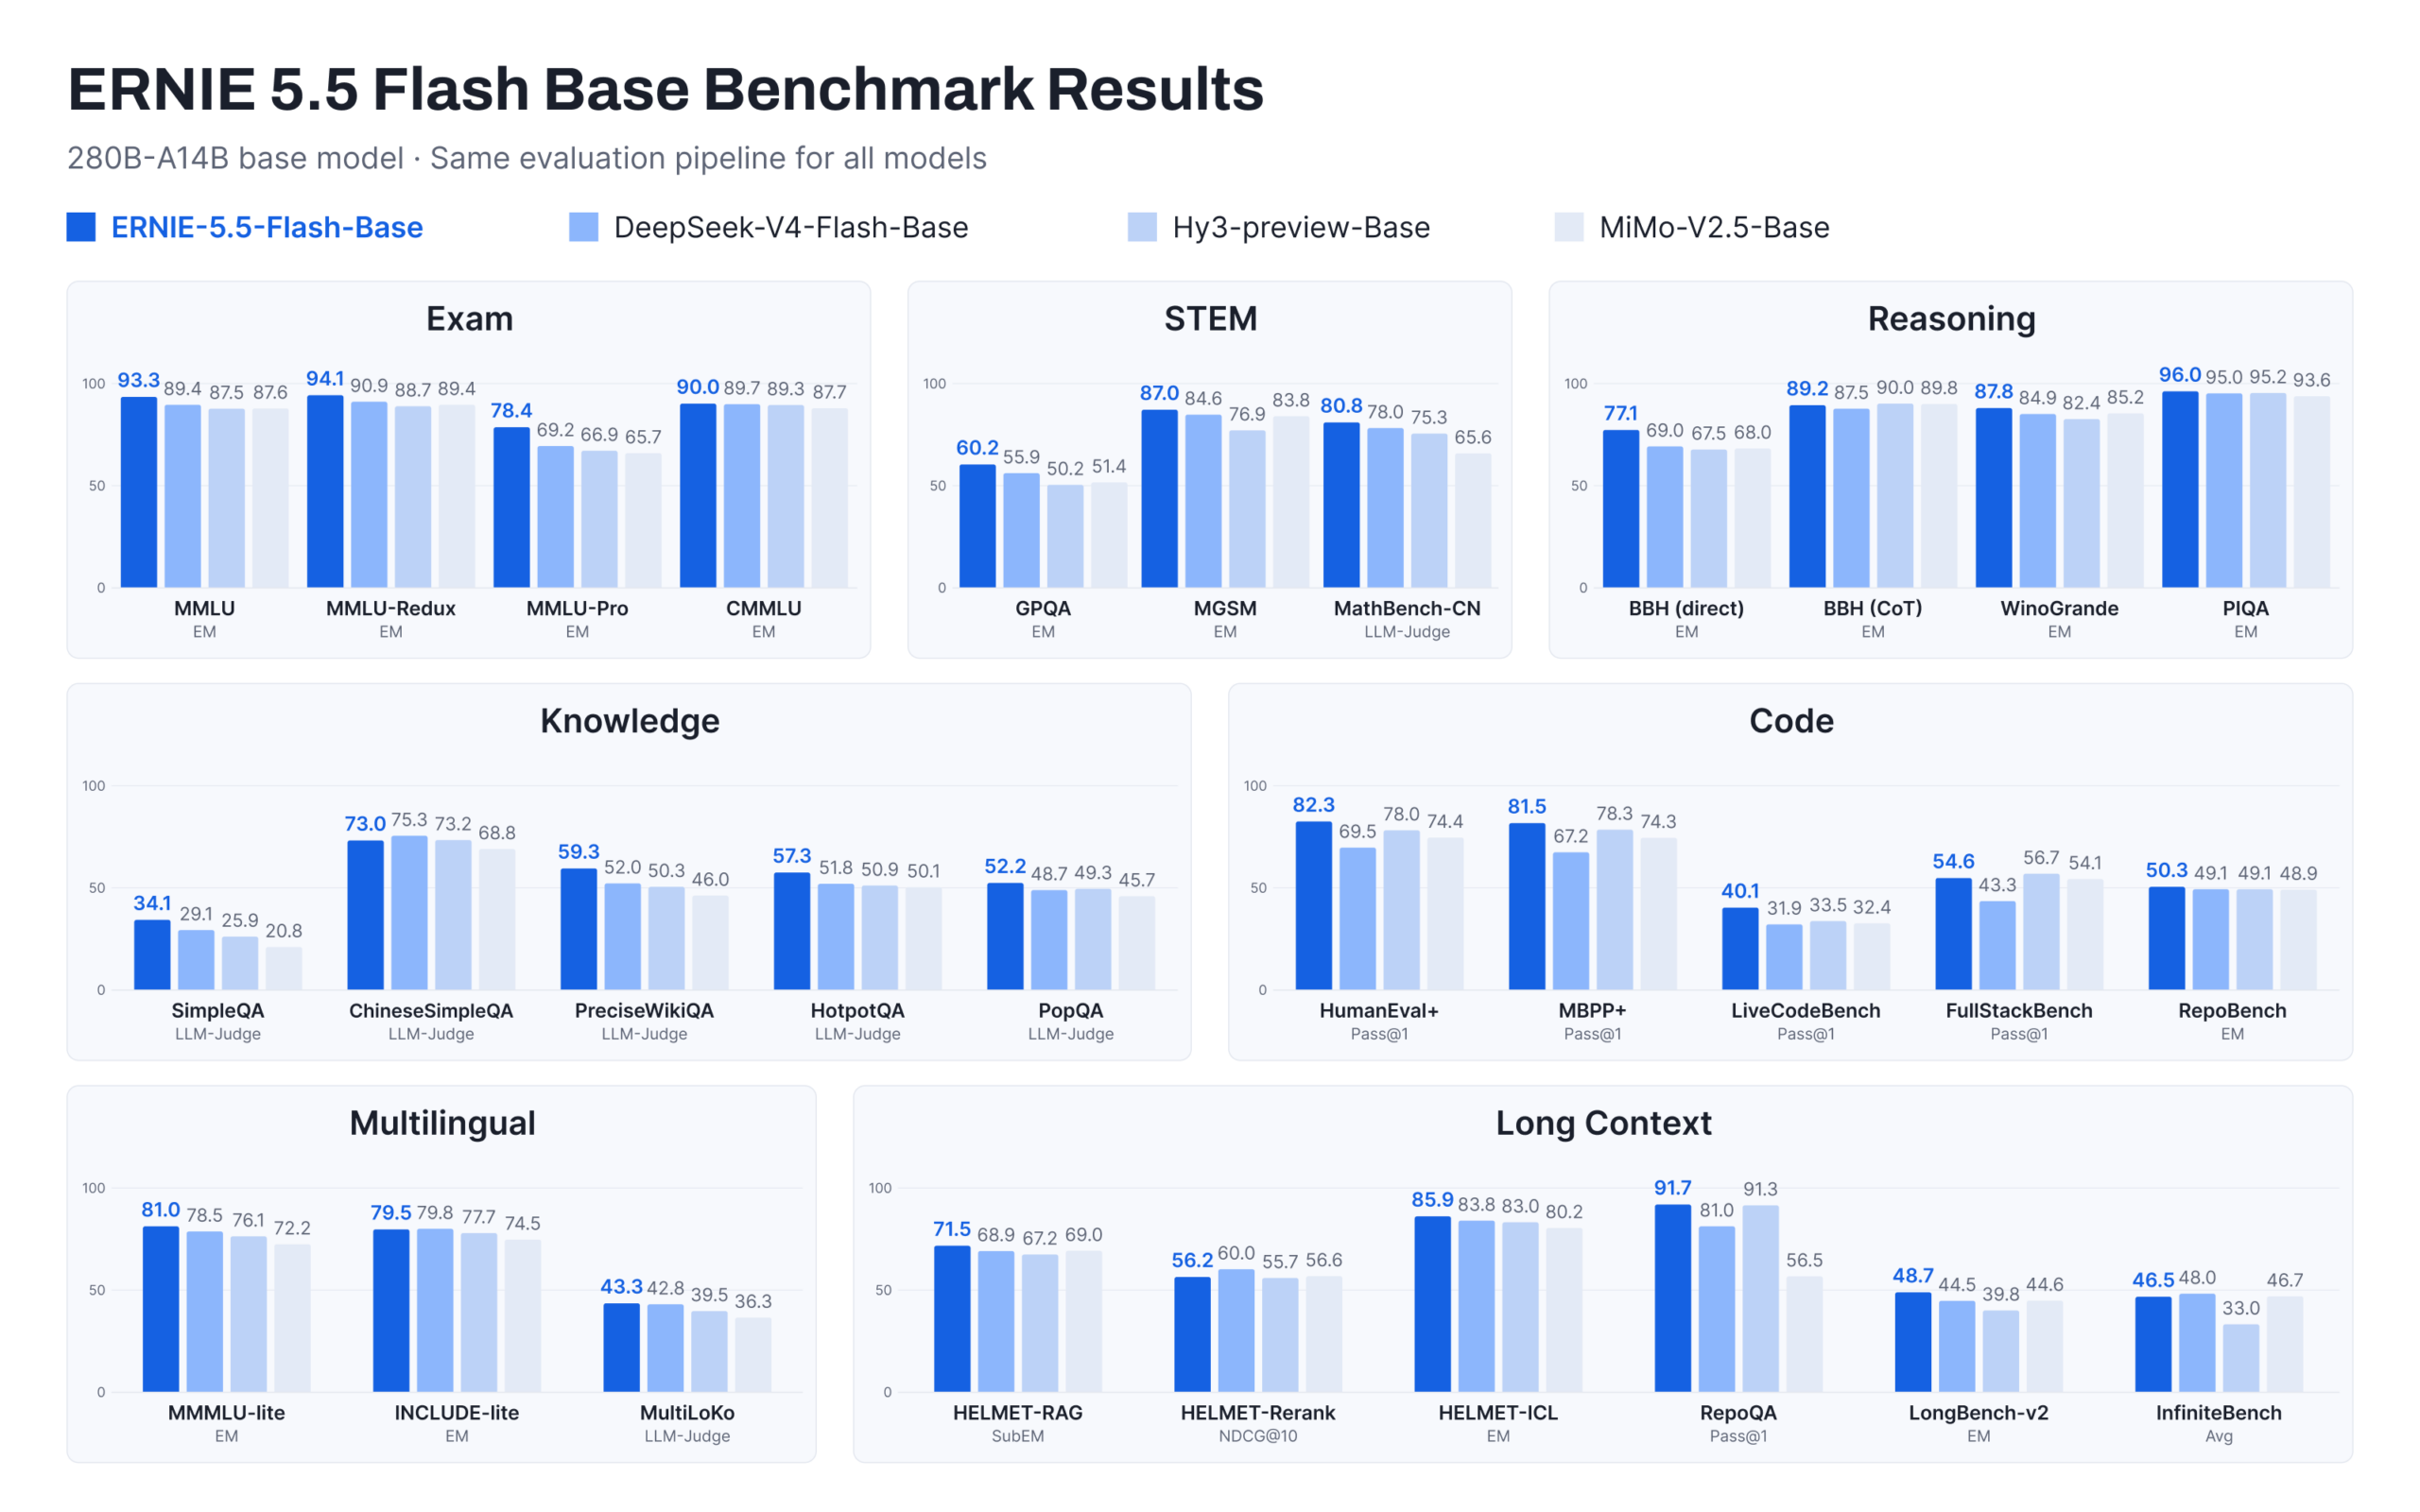
成绩方面,百度在统一评测管线下把它与 DeepSeek-V4-Flash-Base(284B-A13B)、Hy3-preview-Base、MiMo-V2.5-Base 同场对比,自称同级综合领先:MMLU 93.3 对 89.4、MMLU-Pro 78.4 对 69.2、HumanEval+ 82.3 对 69.5、LiveCodeBench 40.1 对 31.9、RepoQA 91.7 对 81.0。也有个别项没赢:ChineseSimpleQA 73.0 对 75.3、FullStackBench 54.6 对 56.7。全部成绩均为百度官方数字,尚无第三方独立复现,对照的也不是各家最新模型。
许可证值得单独提醒:它用的不是 Apache 2.0,而是百度自定的 ERNIE 5.5 Flash Base Model License v1.0——授权地域排除欧盟、英国与韩国,相关年收入约 5000 万美元以上的商业使用须另获授权并标注“Powered by ERNIE”。拿去商用之前,先读一遍 LICENSE。带 post-training 的完整版 ERNIE 5.5 Flash,百度称随后就到。
这是继 Kimi K3.1 Pro 权重上线、Mistral Large 4 开源权重之后,又一个 280B 级开源底座。开源节奏还在加速,但 Base 模型的门槛在部署与调教,不在下载本身。
来源:百度 ERNIE(Hugging Face 模型卡),原文:https://huggingface.co/baidu/ERNIE-5.5-Flash-Base

没有回复内容