

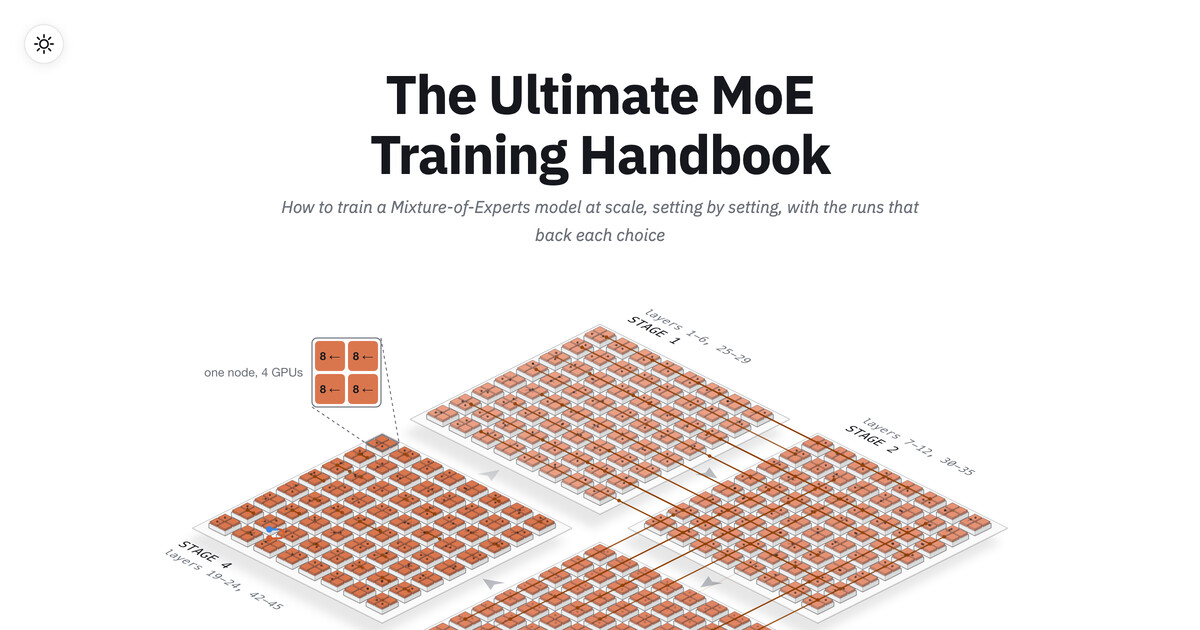
想真正搞懂 MoE(混合专家)训练,Hugging Face 刚放出一份免费的硬核教材。11 月 5 日,Thomas Wolf 带领的 Hugging Face 团队发布《The Ultimate MoE Training Handbook》(终极 MoE 训练手册):约 7 万字、55 张交互图、附可运行代码,免费在线读。内容来自团队自己在 Alps 集群上约 80 万 GPU 小时的 Megatron-LM 实验,讲的全是 MoE 训练真正会踩的坑,而不是理论综述。
先看结论:MoE 已经是前沿的默认形态
手册开篇给了一个数字:在 Artificial Analysis 的榜单上,20 个得分最高的开源权重模型里有 18 个是 MoE——DeepSeek、Qwen、GLM、MiniMax 等各家最强的模型全是 MoE,只有 2 个是稠密模型。MoE 的核心账很好算:一个 token 只经过少数几个专家,模型总参数可以很大、每次实际激活的却很少。手册里手把手训的那个小 MoE 就是 68.6 亿总参数、每个 token 只激活 12.2 亿。
手册讲了什么
全书分四章,难度递进:
第 1 章:入门。从稠密模型到 MoE 多出的三个新难题:路由器(决定每个 token 去哪个专家)、专家之间的负载均衡、专家分到不同 GPU 之后每层都要做的 token 交换(all-to-all 通信)。还附了一张“训练出问题时的排查地图”:先看症状,再顺着找原因。
第 2 章:环境与第一次运行。所有命令按一种机器写:8 卡节点的 Slurm 集群,Enroot + Pyxis 起容器,NVIDIA PyTorch 镜像加 Megatron-LM 固定版本。先测硬件再开训:用 NVIDIA DCGM 做就绪检查,再用 nccl-tests 测 all-to-all 带宽——不同节点数要对照不同基线(2 节点 77.14 GB/s、4 节点 39.25 GB/s、8 节点 30.91 GB/s)。没有集群也能读:分词等部分能在单机 CPU 上跑,训练配方则按“读方法”来学。
第 3 章:MoE 训练解剖。把 MoE 层拆开讲:每个部件是干什么的、前沿模型各自怎么选、证据是什么。包括专家数量、路由方式、负载均衡,以及 DeepSeek 式的无损均衡(loss-free bias)与传统辅助损失(aux loss)的实测取舍。
第 4 章:部署与强化学习。把第 3 章的选择带过预训练,讲到 serving 和 RL 阶段;一个实用结论是:推理时往往可以用比训练时更小的 top-k。
几个值得记住的实测数字
手册里最有价值的是团队自己跑出来的测量,而不是建议清单:8×H100 的一次运行里,半个训练步都耗在暴露的 all-to-all 通信上;强制均匀路由在一次测量里让迭代时间快了约 40%;走 socket 回退路径时,一次运行会悄悄慢 25 倍、日志里却没有任何报错——典型的“看着一切正常、就是慢”的故障。手册的方法论就一句话:一次只改一个变量,拿测量说话。
谁适合读
按手册自己的说法:如果你已经在 GPU 集群上训过稠密模型、接下来想训 MoE,这本就是为你写的;如果你只是好奇前沿模型内部怎么选,可以直接跳到第 3 章通读,不用跑任何东西。读的时候注意:这是一份免费在线的手册,不是可下载的资源包,所以放在本站的免费资源栏目;想系统学 MoE 训练、又不想只看二手解读的人,可以直接打开原文按章节读,阅读时间约 1–2 天。
想先看 MoE 模型在消费级硬件上怎么跑,可以对照:12GB 显卡跑 763B 大模型:DeepSeek-V4.1-Flash GSQ-RCO;想看小参数 MoE 的实战表现,可以看Ripple-65B:65B 小模型叫板 500B+ 巨兽。
转自 Hugging Face 团队的文章《The Ultimate MoE Training Handbook》,原文链接:https://huggingface-moe-blogpost.hf.space/

暂无评论内容