

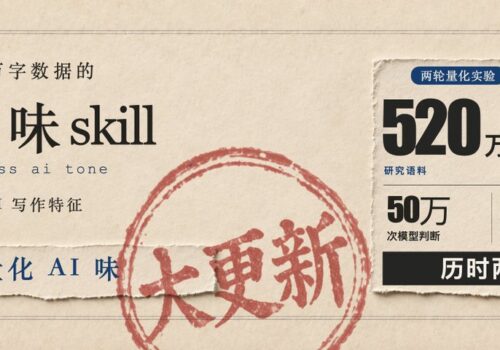
躺在废墟里 Lieflat(@lieflat_3,前记者、GitHub 万星开发者)花了两个月做了一个语言学实验:量化到底什么是「AI 味」。两轮实验一共 1169 篇文章、约 520 万汉字,100 多项指标,50.7 万次模型语义判断,烧了近 4 亿 Token,最后做成了 lieflat-less-ai-tone 这个 Skill,全部开源在 GitHub 上,目前 5166 星(我核过,作者说的 5k+ 属实)。
实验是怎么做的:核心思路是把优秀的人类真实文章当基准,和 AI 生成的文章对照,差异的部分就是「AI 味」。第一轮让 5 个主流模型(Claude Opus 4.6、GPT-5.6、DeepSeek、Gemini、Kimi)写了 300 篇,跟 329 篇人类文章对比,但发现了一个致命漏洞:两边写的根本不是同一篇东西——人类写财报全是数字,AI 写行业漫谈没几个数字,算出来「人类的数字密度是 AI 的 3 倍」说明不了问题。第二轮改成同题、同事实、同长度配对生成,这样测出来的差异才真正属于 AI 的写作习惯。
三层测量:第一层用 Python 脚本,把标点、句长、分节这些能用数字算出来的 90 项指标全算一遍,光这些句子特征训一个分类器,区分真人和 AI 的准确率就到了 97.6%;第二层用模型做语义判断,对付脚本看不懂、必须理解上下文的特征,50.7 万次判断,每条结果带置信度存在本地 JSON 文件里,随时可以复查;第三层连大模型都搞不定的(比如比喻到底贴不贴切),作者直接一条条人工盲读。
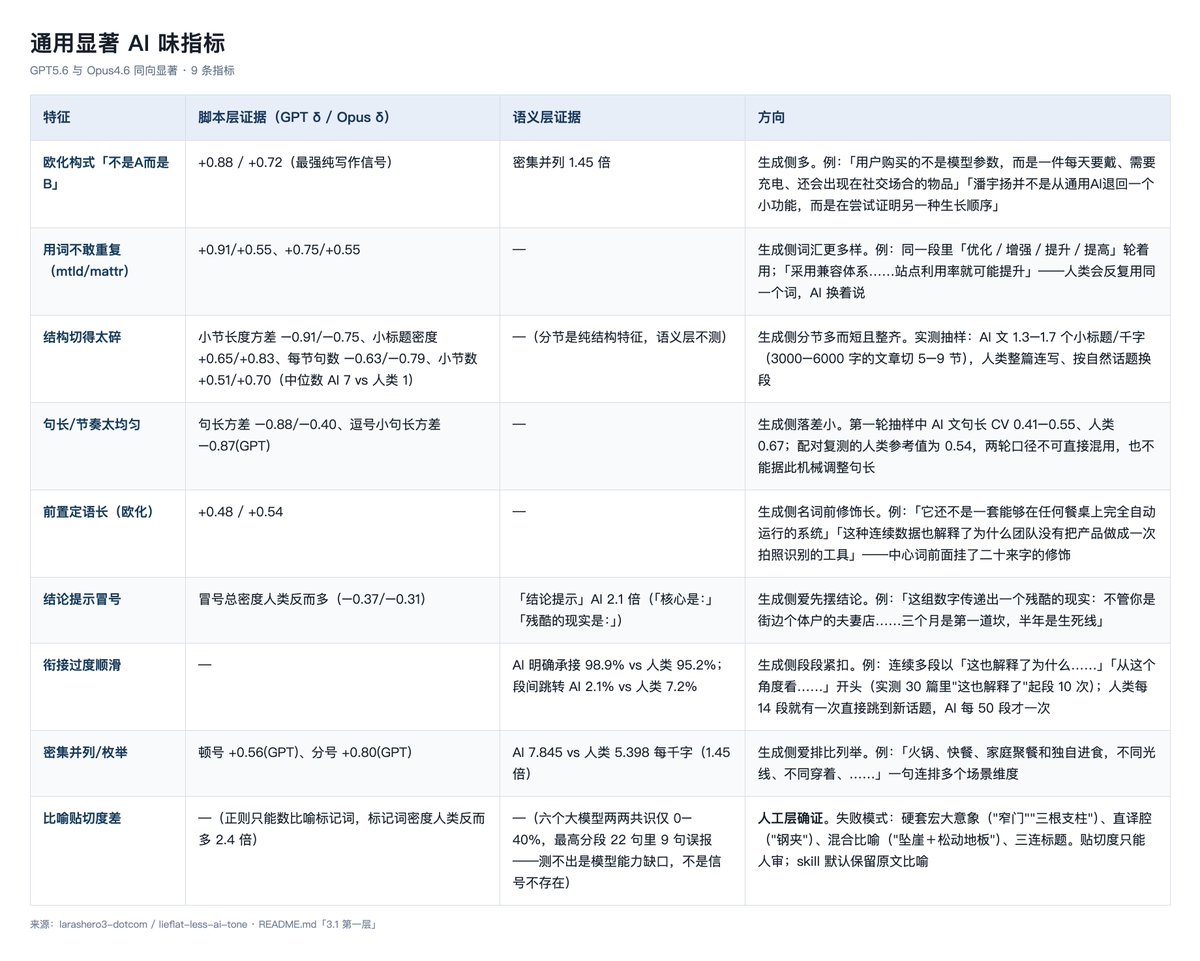
结论:9 项通用核心指标 + 9 项模型特有偏好。通用指标里既有大家熟悉的句式套路,也有更隐蔽的习惯,比如用词不敢重复,还有衔接过渡太顺滑(93% 的文章连续 6 段以上都首尾紧密衔接,不给读者喘气空间)。
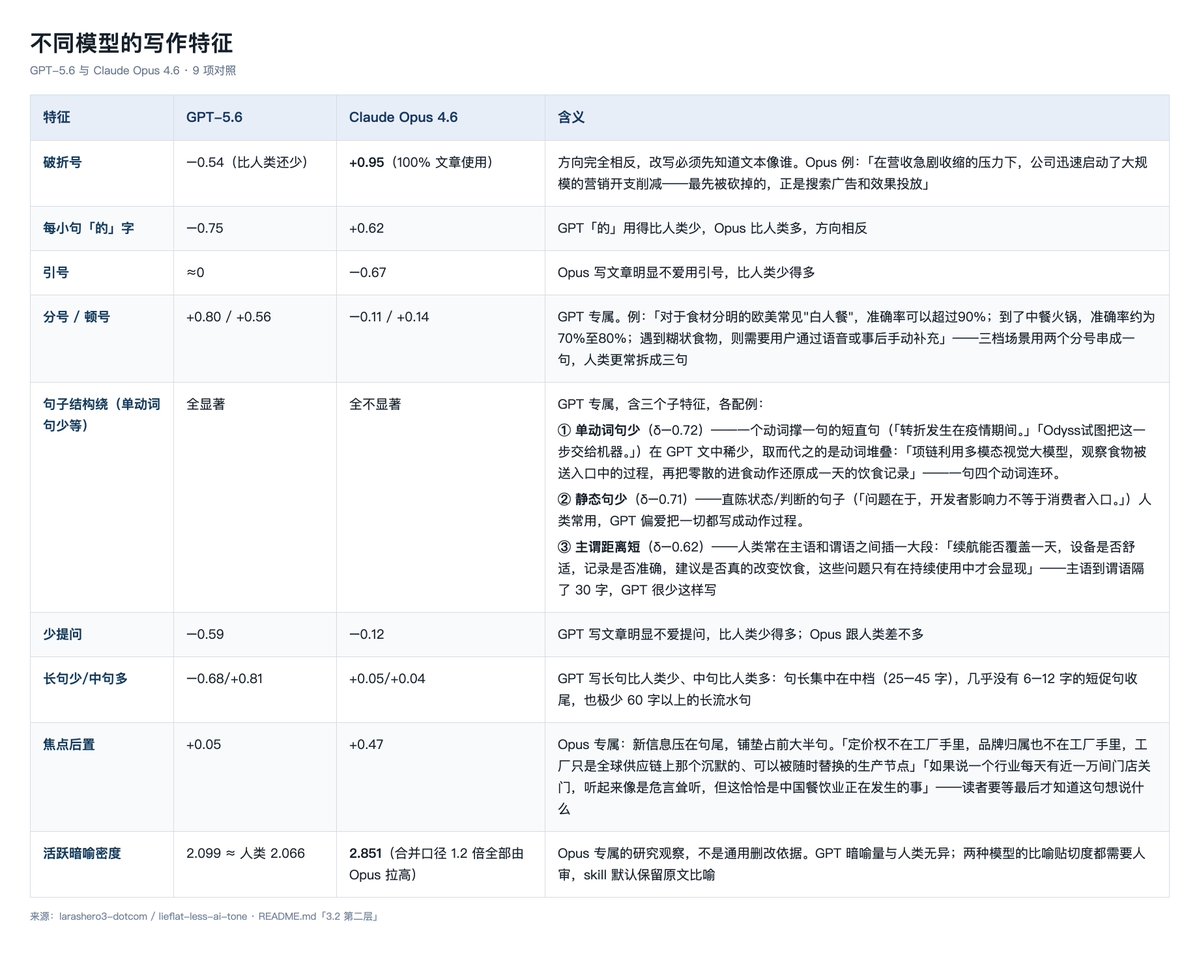
不同模型各有偏好,比如 GPT-5.6 和 Claude Opus 4.6 在标点和句法上的表现常常相反:Opus 特别爱用破折号,GPT 特别爱堆砌动词。
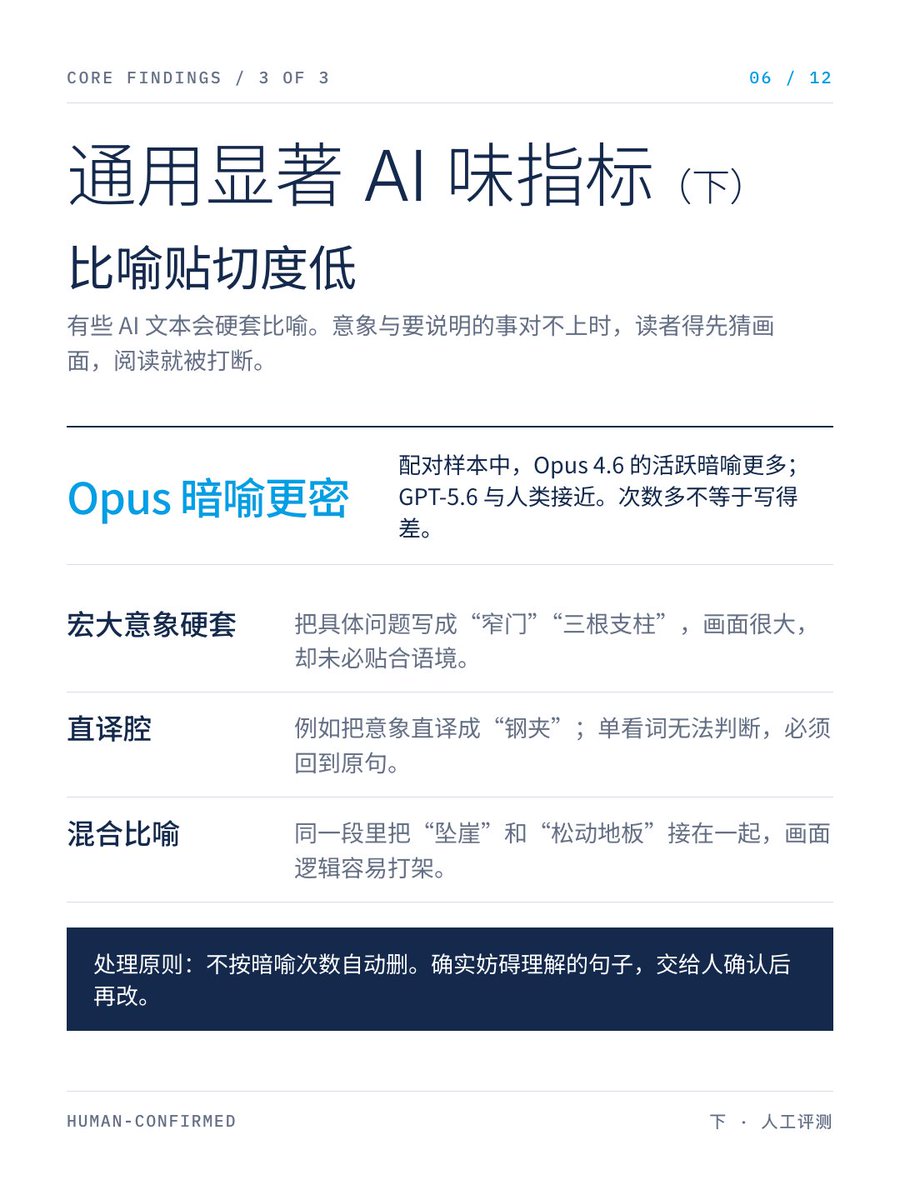
四个代表性发现:
1、比喻:问题不在数量,在贴切度。人类用比喻的频率反而是 AI 的 2.4 倍。AI 没有身体和感知,比喻靠词语在语料里的统计关联算出来,所以会写出「数据难看得很平静」这种近乎诡异的句子。作者的结论很直接:现在 AI 还不会写比喻,很多 AI 味就是不贴切的比喻句造成的。
2、翻译腔:被动句不是信号,「不是 A,而是 B」才是。实验测了 18 种常见翻译腔,普通被动句在 AI 文章里每千字不到 0.09 次,跟正常中文书面语没区别。真正跨模型显著的是「不是 A,而是 B」的对举句式,是人类的 3.4 倍;还有英文直译过来的超长前置定语,300 篇 AI 文章里有 179 篇都有这个问题。
3、密集并列与枚举。一个分句里用顿号连排三项以上,AI 是人类的 1.8 倍;广义的密集并列每千字高出 1.45 倍;三连问句(「叫什么名字?承载什么功能?嵌入哪个生态?」)AI 出现的比例是人类的 2.75 倍。
4、结论提示冒号。冒号总密度人类反而更高,因为真人常用冒号引别人的话。但结论提示类冒号 AI 是人类的 2.1 倍,固定提示语(「核心是:」「关键在于:」「一句话总结:」)约 4 倍。说人话就是,真人用冒号引别人的话,AI 用冒号给自己下结论。
Skill 怎么用:先检查,再修改,人点头了才准改。第一版是照着规则直接全文改一遍,容易误伤——AI 味里一半是整篇文章的结构问题,逐句改会把正常句子改碎。新版改成:对 Agent 说一句「帮我用去 AI 味 Skill 处理一下这篇文章」,它先在后台调脚本和语义判据给一份检测报告,等你看完回复后才真正改;改写只允许在命中的地方做最小改动,同目录里有你自己的风格指南一律以个人习惯为准;改完自动复测,在本地生成一个独立的网页文件汇报效果。
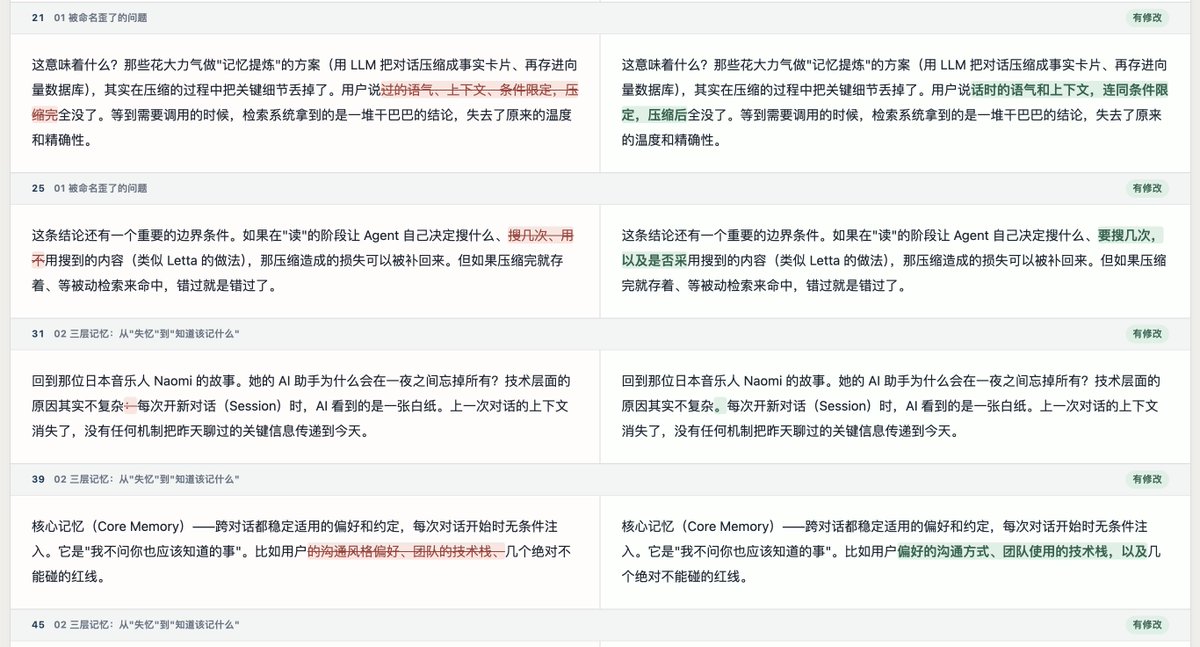
三点提醒:第一,数字口径——标题与正文用 520 万字,原文结尾一处写 538 万字,以 520 万字为准,仓库 README 也是 520 万字;第二,仓库目前没有声明开源协议(GitHub 显示无协议),作者说已全部开源,使用前留意;第三,与本站公众号 008《去 AI 味:5个方法让 AI 出图不再像 AI》不重复,那篇讲出图,这篇讲写作。
站内相关:之前介绍过的 unslop 也是去 AI 味的路子,可以对照看;想了解 Skill 在 Claude Code 里怎么用,看这篇斜杠命令与技能的配合方式。
开源地址:https://github.com/larashero3-dotcom/lieflat-less-ai-tone
转自 X @lieflat_3,原文链接:https://x.com/lieflat_3/status/2118355780474937831

暂无评论内容