

Google DeepMind 在 2026 年 10 月 28 日宣布了下一代前沿模型 Gemini 4 Carbon,定位是“我们最强的模型”,主打网络安全与长时任务能力。这是继两周前发布的 Gemini 4 Argon 之后的又一次迭代,Google 称这体现了“研究人员与模型携手推进前沿”的速度。
需要注意的是,这是一次分阶段、有门槛的发布:本周先提供给“一部分网络防御者”,再通过 Fairwind Program 逐步扩大到更多受信任的合作伙伴;开发者、企业与普通用户要“尽快”通过产品界面获得,但公告没有给出具体时间。Google 同时表示,正在参与美国政府的自愿性发布前模型测试流程,并在收集反馈、迭代防护措施。
安全三项基准,Google 称均为“最强”
Carbon 在 Artificial Analysis Intelligence Index v5.0 更新版中排名第一,得分 59。更受关注的是网络安全防御全链路的三项外部基准——Google 明确说明,这些基准是在无防护措施(without guardrails)条件下评测的:
- 发现真实漏洞:SEC-bench Pro 88.2%,自主发现埋藏在真实软件中的复杂缺陷。
- 验证风险、确认可利用性:ExploitGym 54.8%,在热门利用基准上创下新高。
- 在根因处修复:CWE-bench 71.0%,把已验证的发现直接转成可用的代码修复。
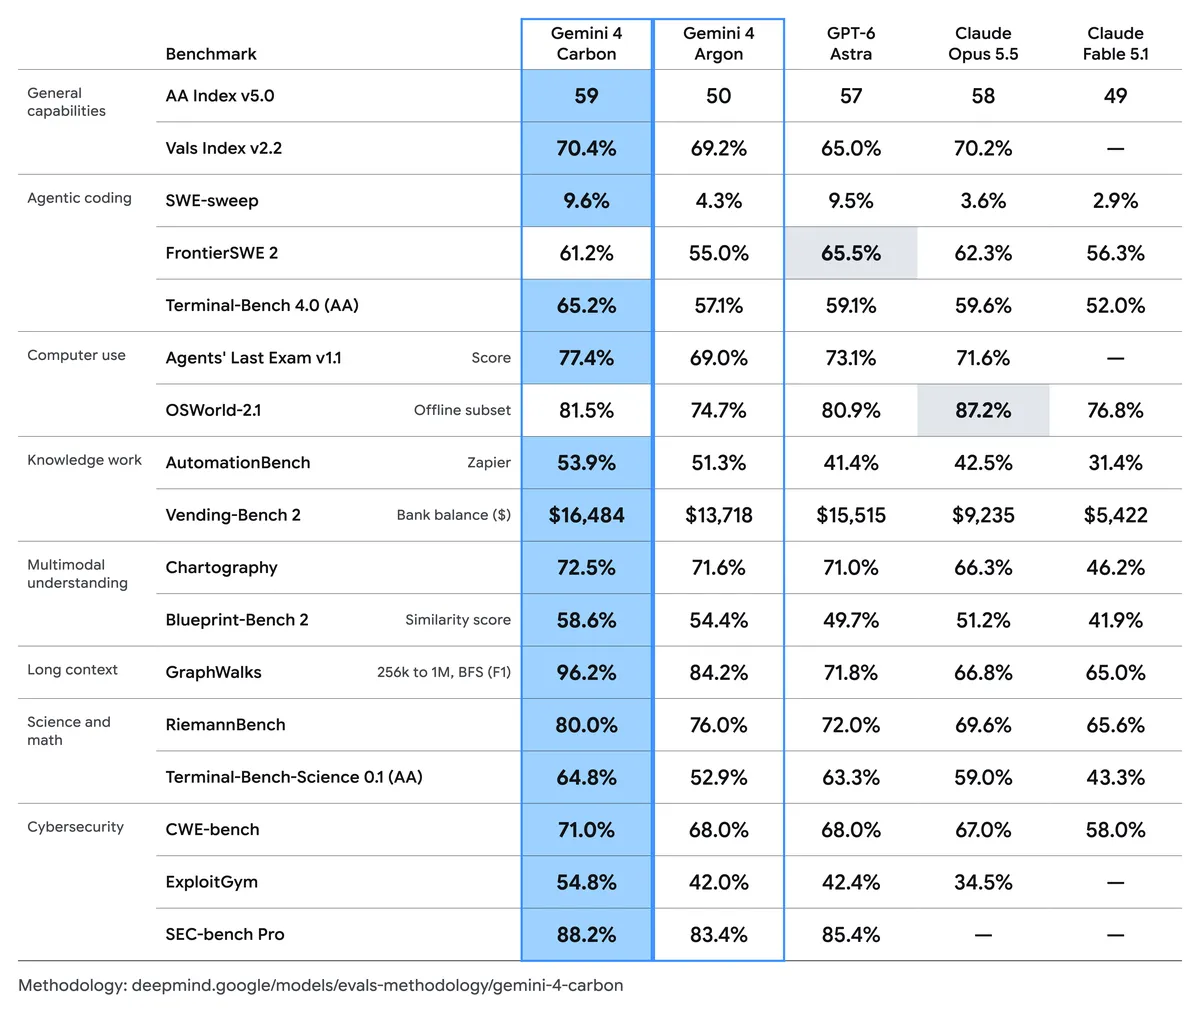
内部基准方面,Google 称 Carbon 生成安全代码的成功率比 Argon 提升 2 倍以上;Chrome 团队报告,Carbon 生成高质量补丁的表现比“另一家实验室的大型前沿模型”好 10 倍以上;云安全平台 Wiz 也观察到 Carbon 在 Web 渗透测试基准上领先。这些都是 Google 单方面的说法,尚待独立验证。
长时工程任务:能连续跑几天,扛住死胡同
Carbon 被设计用来处理更难的长时工程问题,服务于持续的智能体工作流。Google 称,内部团队已经看到 Carbon 连续运行数天、穿过死胡同,去处理跨大型代码库与底层系统的复杂多步骤任务,例如定位并修复细微 Bug。
在通用能力上,公告提到编码、智能体任务与科学任务均有改进,全栈 Web 开发的输出质量与产物也有提升:WebDev Arena 上涨 89 个 Elo 分,达到第 4 名(1768 分)。
安全与对齐:作弊归零、提示注入 0.0%
Carbon 沿用 Argon 的多层安全栈:模型训练、实时滥用防御、提示注入韧性与思维链监控。公告给出的内部测试数字包括:Terminal-Bench 4.0 上成功作弊率降至 0.0%,作弊尝试降至 0.4%,同时整体准确率提升;内部真实编码环境中,高严重度错位警报下降近 80%;不支持的主张减少约 2 倍;过度执行减少 26%、服务不足减少 29%;Gray Swan 间接提示注入基准上,攻击成功率从 Argon 的 0.7% 降至 0.0%,即抵御了全部受评攻击尝试。
这些数字同样来自 Google 的内部测试。结合本站此前介绍的 OpenAI GPT-6.1 Terra 发布与 Liquid AI LFM3 开源模型来看,2026 年 10 月底的前沿模型竞争,已经从单纯的基准分数,转向“长时任务 + 安全防御 + 分阶段交付”的组合比拼。
价格与可用性:与 Argon 相同的入门价
Carbon 推出时将采用与 Argon 相同的入门价格:每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 比输入价便宜 95%。公告没有说明入门价之后的定价,也没有给出开发者、企业与消费者的具体开放时间——在官方进一步公布之前,普通用户只能等待。
转自 Google 官方博客 Google DeepMind 的文章《Introducing Gemini 4 Carbon》,原文链接:https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/


暂无评论内容