
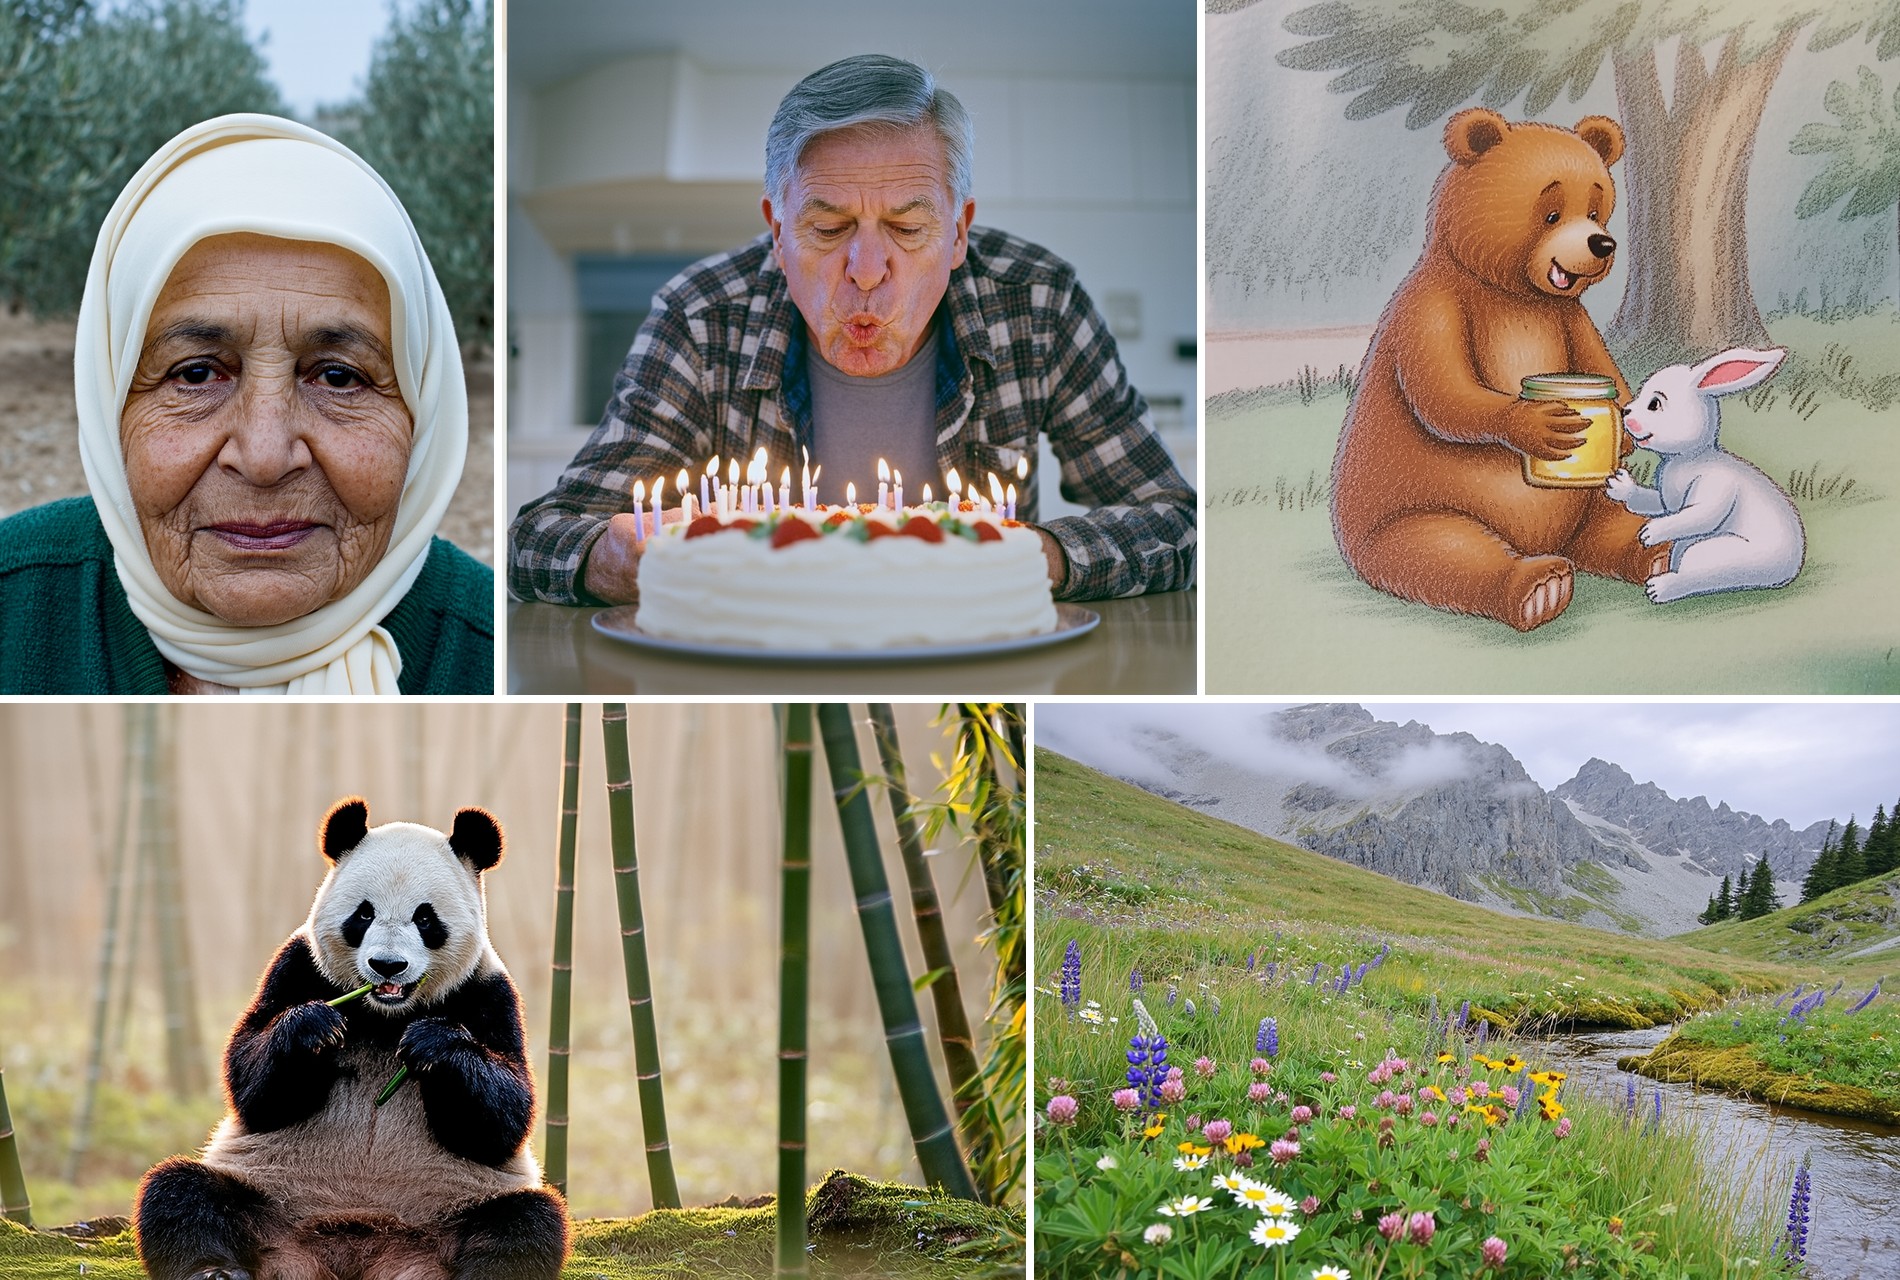
只有 2 名研究员的 AI 研究组织 Linum 今天公开了图像生成模型 P-JiT 21K:一个 20 亿参数的像素空间文生图模型,整个训练只花了 21038 美元,权重与代码已按 Apache 2.0 协议开源,在 Hugging Face 与 GitHub 上均已上线。
便宜的关键在于它干脆不要 VAE。大多数生图模型先用变分自编码器把图片压进隐空间再生成,Linum 认为 VAE 的压缩存在上限,而且修 VAE 未必能帮到下游的扩散模型。P-JiT 直接在像素空间里做扩散:把 512×512 的图片切成 32×32 的色块、压进 1024 维,再让扩散模型自己学一个为生成服务的隐空间,token 压缩做到 32×32,比常规的 16×16 激进一倍,注意力上下文窗口随之缩小 4 倍;配合沿 DiT 主干的多处读出头给早期模块补梯度信号,收敛所需的样本数比上一代 Linum v2 少 11 倍。
账单明细全部公开:预训练 610M 样本在 512 分辨率、50M 样本在 1024 分辨率,共 8139 个 H100 小时、20348 美元;后训练用了有限差分流优化(FDFO)加人工评审,276 个 H100 小时、690 美元;合计 8415 个 H100 小时、21038 美元。文本编码器用的是冻结的 Qwen3.5-4B。Linum 自己也提醒,这只是通往视频模型路上的一次“压力测试”:模型很小,画全身、多人互动、拥挤场面还吃力,也没学过带文字的图片,所以写不了字、做不了海报和信息图。
为什么值得关注:它把“训一个能用的生图模型”这件事的成本从百万美元量级打到了 2 万美元,而且全套做法都公开了。对小团队和独立研究者来说,这条像素空间路线如果能继续放大到 70 亿参数和视频上,可能会改变“只有大厂才玩得起生成模型”的格局——当然,现在的版本还只是实验性质的研究产物,不是生产模型。同类效率优化可以参考英伟达开源的 Reshard,而图像生成产品的最新进展可看 OpenAI Images 2.6。
来源:Linum 官方博客,原文:https://www.linum.ai/field-notes/pjit-21k;权重:https://huggingface.co/Linum-AI/pjit-21k

没有回复内容