
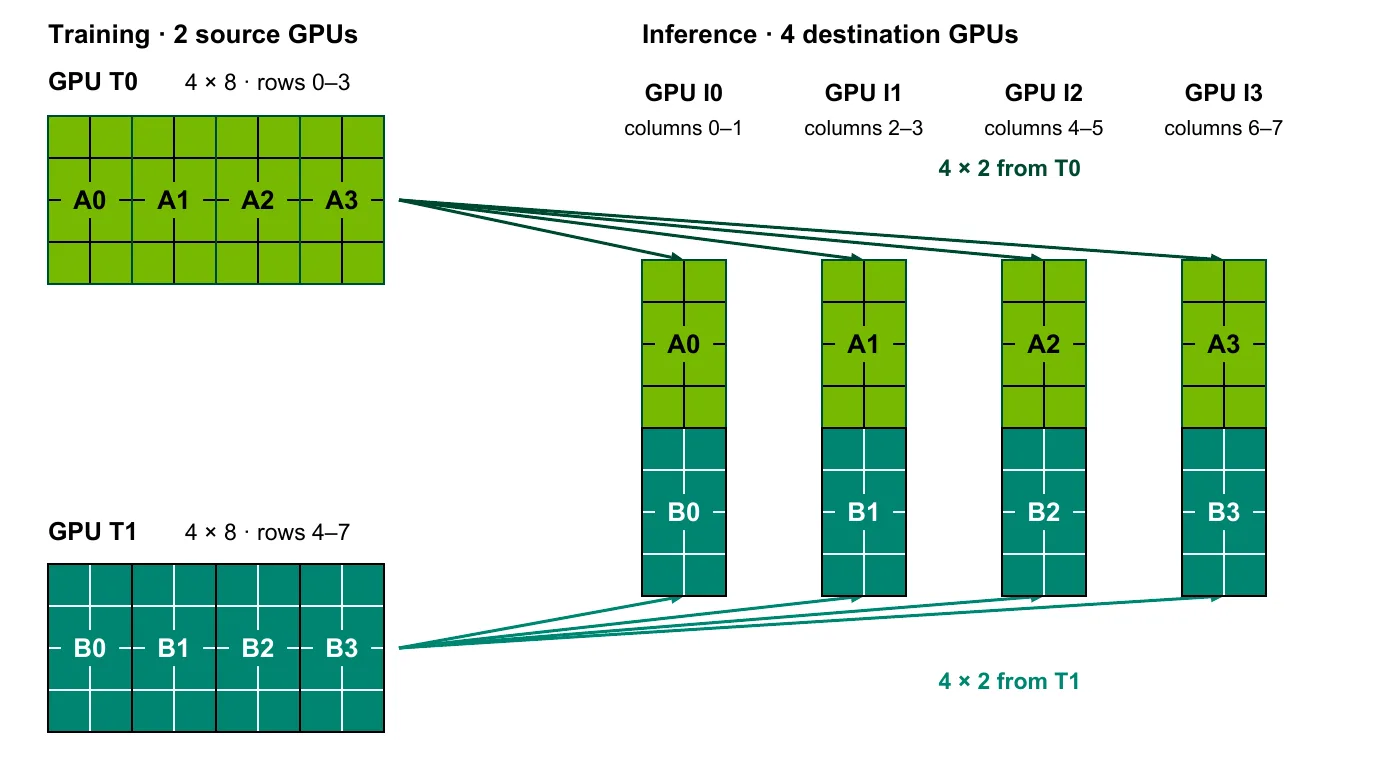
英伟达 11 月 6 日在 开发者博客发布 Reshard 集合通信,专治强化学习后训练里一个昂贵的环节:每训练一步,都要把训练 GPU 上更新后的策略权重同步到推理 GPU,这一步叫 refit。开源参考实现 NCCL M2N Reshard 已放进 NVIDIA/nccl-extensions 仓库,NeMo RL 框架也已接入。
问题有多大:传统做法先全量聚合再广播,逻辑流量约等于模型权重的 2 倍。按 BF16 权重算,Kimi K3(2.8 万亿参数)权重约 5.6TB、一次 refit 的逻辑流量约 11.2TB;Qwen3.8 2.4T 权重约 4.8TB、流量约 9.6TB,而且每个训练步都要来一次。Reshard 把 refit 重新表述为 PyTorch DTensor 到 DTensor 的重新切分,只传源分片与目标分片重叠的部分;再按 NVLink 域给目标副本分组,每份数据只过一次网络,其余在域内走 NVLink 交换。
实测数据均为英伟达自测:NeMo RL 的 4 组基准里,refit 延迟比传统方式快 2.7 至 5.7 倍——DGX H100 上 Qwen 3 235B 从 6.4 秒降到 1.9 秒、DeepSeek v3 671B 从 14.9 秒降到 2.6 秒;DGX GB200 上 DeepSeek v3 从 6.1 秒降到 2.3 秒、Nemotron Ultra v3 从 8.2 秒降到 2.3 秒;万亿参数规模的 Qwen3.8 2.4T 微基准一次 refit 只要 4.3 秒。要注意:测的是 refit 延迟,不是端到端训练速度,博客没有给出 refit 占整个 RL 步的比重,不能直接换算成训练整体加速。
限制也不少:NeMo RL 文档把该功能标为实验性,要求 Megatron 训练后端加 vLLM 或 Megatron 生成后端,SGLang 与 TRT-LLM 暂不支持;占参数约 95% 的前馈投影权重走 Reshard,较小的权重仍走传统路径。但对动辄几万亿参数的模型,权重同步已占到 RL 步时间的近三成(DeepSeek-V3 在 256 卡上为 29.4%),省下的每一步都会累积。英伟达最近在 AI 基建上动作不断,10 月底刚 30 亿美元入股 Meta,加码 Muse 合作。
来源:NVIDIA 开发者博客,原文:https://developer.nvidia.com/blog/accelerating-reinforcement-learning-weight-refit-with-the-reshard-collective/

没有回复内容