
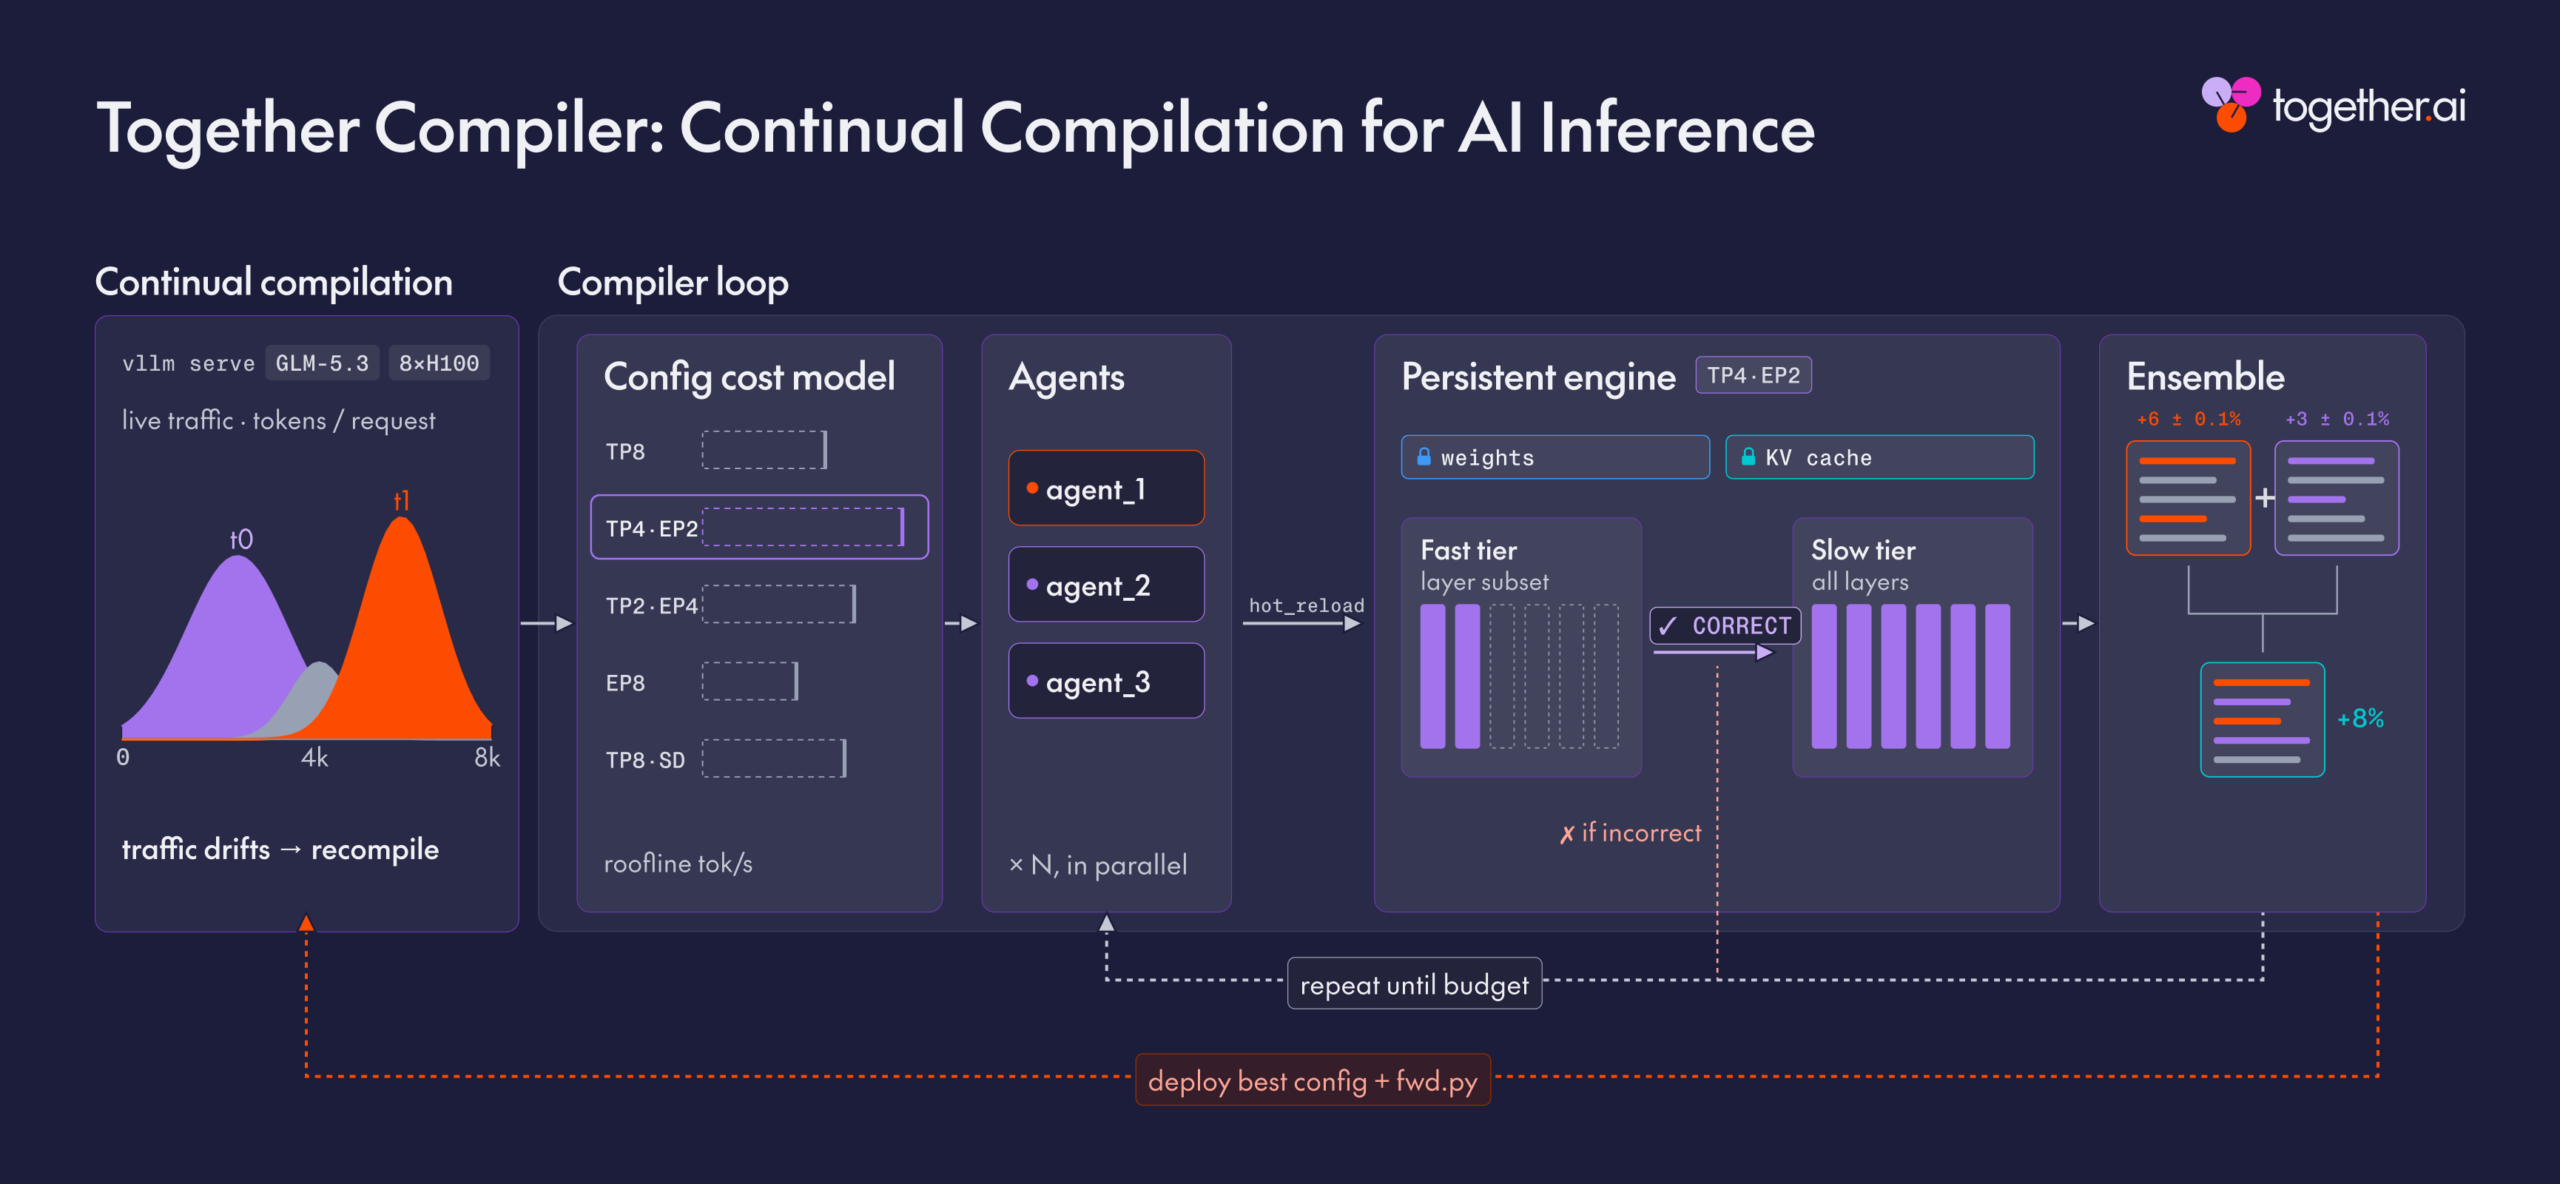
Together AI 在 11 月 4 日发布了 Together Compiler(TKCC):一套用智能体给推理引擎“边跑边调”的持续编译系统。它让多个编码智能体持续改写模型前向传播的 GPU 代码,新开源模型上线后不到 24 小时就能跑得更快,而不用像过去那样等几周人工调优。目前 TKCC 已在 Together 多个无服务器端点上运行,每天服务的 token 量以万亿计。
按 Together 公布的数据,在 SemiAnalysis 的 InferenceX AgentX 基准上,TKCC 相对已公开的最优推理引擎配置最高快出 2.6 倍吞吐;低延迟场景(batch size 为 1)下,MiniMax M3.1 Flash 在英伟达 B200 上达到每用户 1111 token/秒,DeepSeek v4.1 Flash 在 GB300 上达到 1205 token/秒;在经典的 Llama 1B 手写 megakernel 对照上也快了 1.7 倍。测试覆盖 Kimi K3、GLM 5.3、MiniMax M3.1 Flash、DeepSeek v4.1 Flash 等前沿开源模型。背后的关键是“持久引擎”:引擎只启动一次,候选优化通过热重载直接换上,不用每次重启,单次上线耗时从 467 秒降到 9 秒,实验吞吐比现有智能体调优系统高 252 倍。
这件事值得关注,因为推理成本正成为开源模型落地的关键瓶颈。把调优本身交给智能体,意味着新模型、新硬件、新流量形态出现时,推理性能可以“过夜”跟上,而不是等人工排期。Together 还把 TKCC 定位为更大计划“多形态推理”(Polymorphic Inference)的第一步,目标是递归式自我改进的推理系统。不过要提醒一句:以上成绩全部是 Together 自报,尚未有独立第三方复核;而且 TKCC 目前只在自家无服务器端点上全面运行,专属部署需要加入 limited beta,自助接入还要再等等。
相关阅读:SemiAnalysis 的 GDPx 智能体评测同样以 InferenceX 体系为参照;TKCC 测试用到的 Kimi K3.1 Pro 权重本周刚开源。
来源:Together AI 官方博客,原文:https://www.together.ai/blog/together-compiler-continual-compilation-for-ai-inference

没有回复内容