

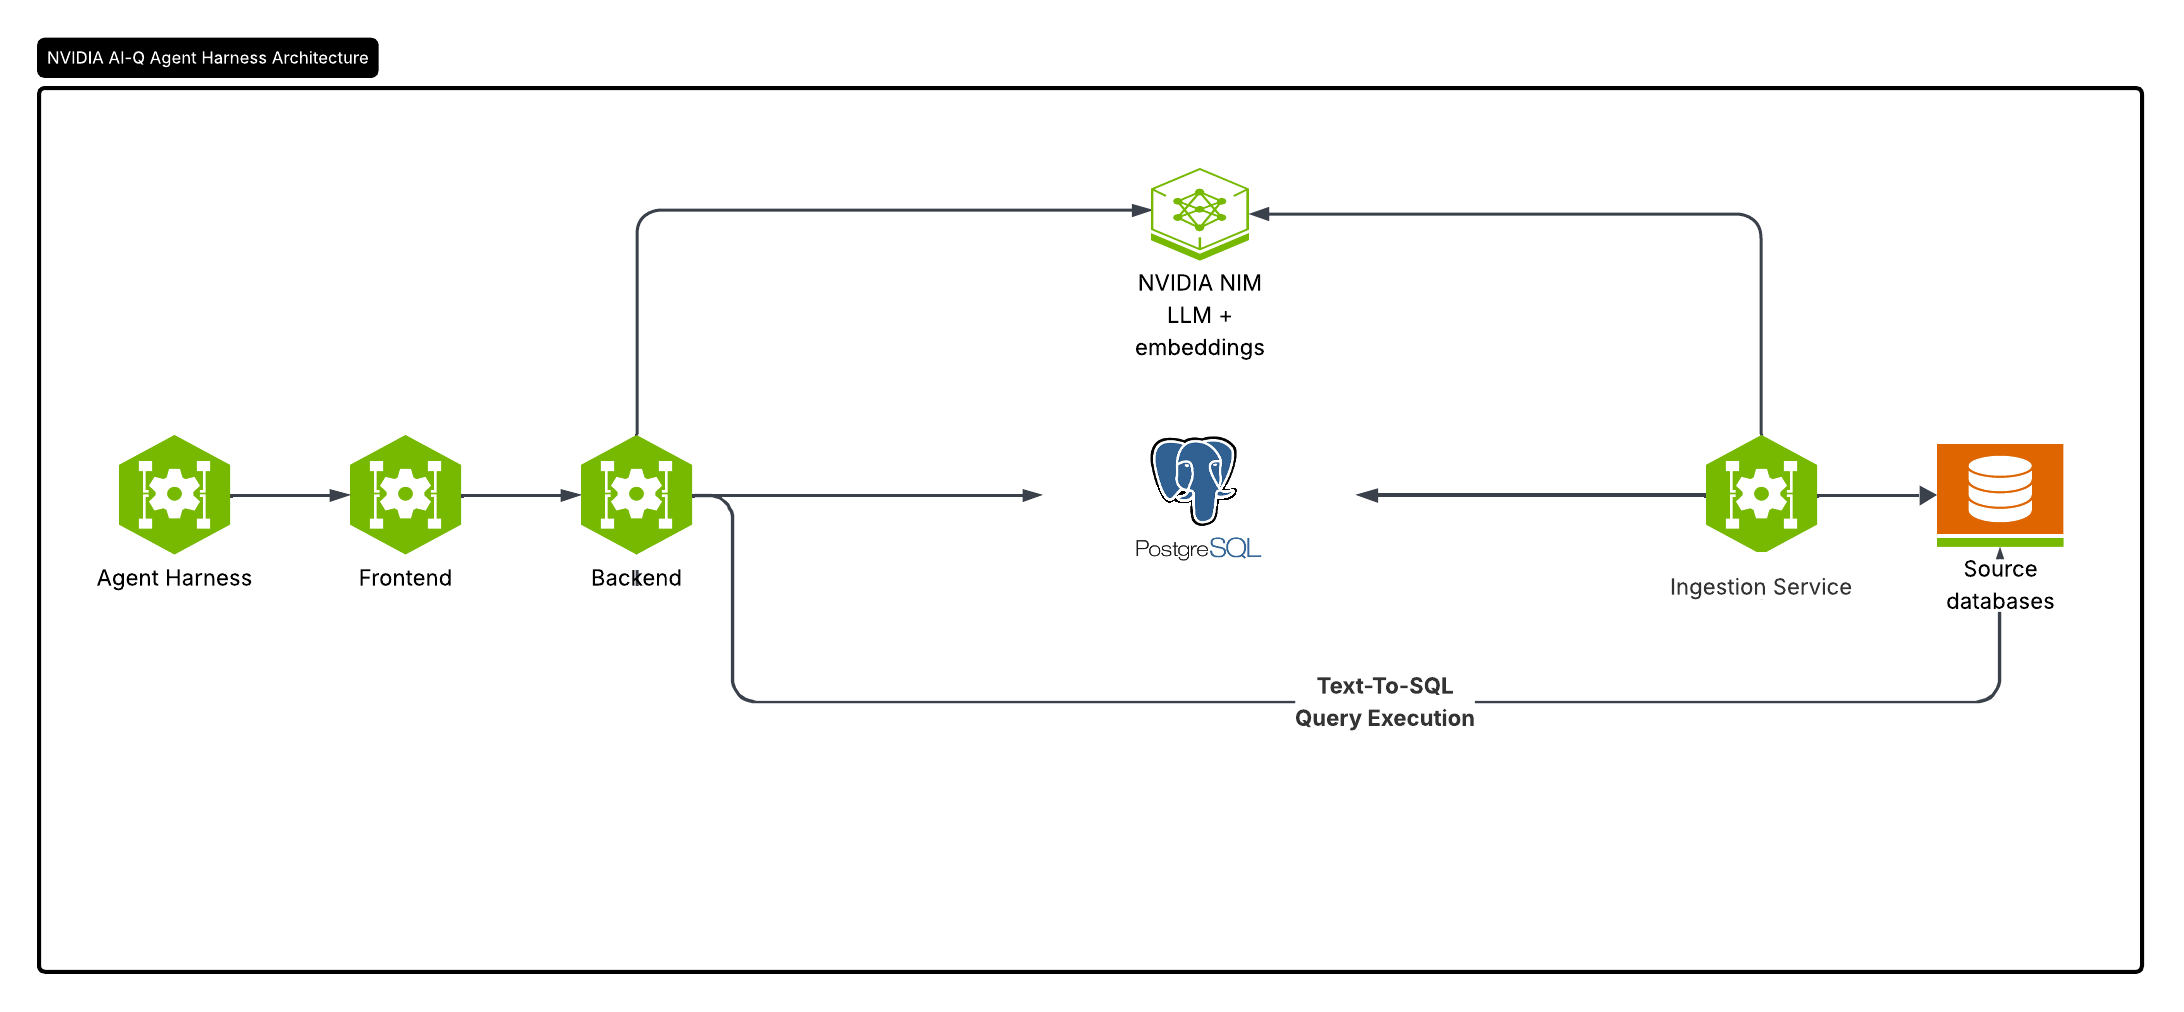
Agent 能查文档、能跑数据库,但可靠性才是 Agent 分析的门槛:一个营收数字算得再快,口径错了就毫无价值。NVIDIA 开源的 Auto Ontology 就是给 Agent 搭一层”上下文”:告诉它数据在哪、是什么意思、该不该用、怎么用、从哪来、和什么相似。
这个 Python 框架从企业元数据自动生成本体(ontology),把定义不一致的地方对齐,再通过 MCP、CLI 和 API 交给任何 Agent 框架使用。11 月 7 日登上 GitHub 热榜,截至发稿 9,400+ 星,Apache 2.0 开源。
它能做什么
- 发现(Discover):从元数据生成企业本体,接上已有的本体和语义模型,建成 AI 可用的知识图谱;
- 锚定(Ground):给 Agent 提供可信的业务含义,统一”营收””客户”这类指标在不同系统里的定义;
- 校验(Validate):拿生成的查询去对照已认证的定义和血缘,每个答案都带出处;
- 暴露(Expose):通过 MCP、CLI 和 API 把上下文交给任何 Agent 框架;
- 学习(Learn):把认证过的修正和实际用法折回本体,共享上下文越用越准。
三步工作流:生成、认证、回答
先是生成:摄取服务读源数据库的 Schema、做列画像、采样值,逐表抽术语并映射到列,再从主键和数据里推断表之间的连接,写成术语、关系和 SQL 属性,存进 Postgres(向量部分用 pgvector)。示例里一次编译 Wide World Importers(微软的示例销售库)生成了 31 个术语。
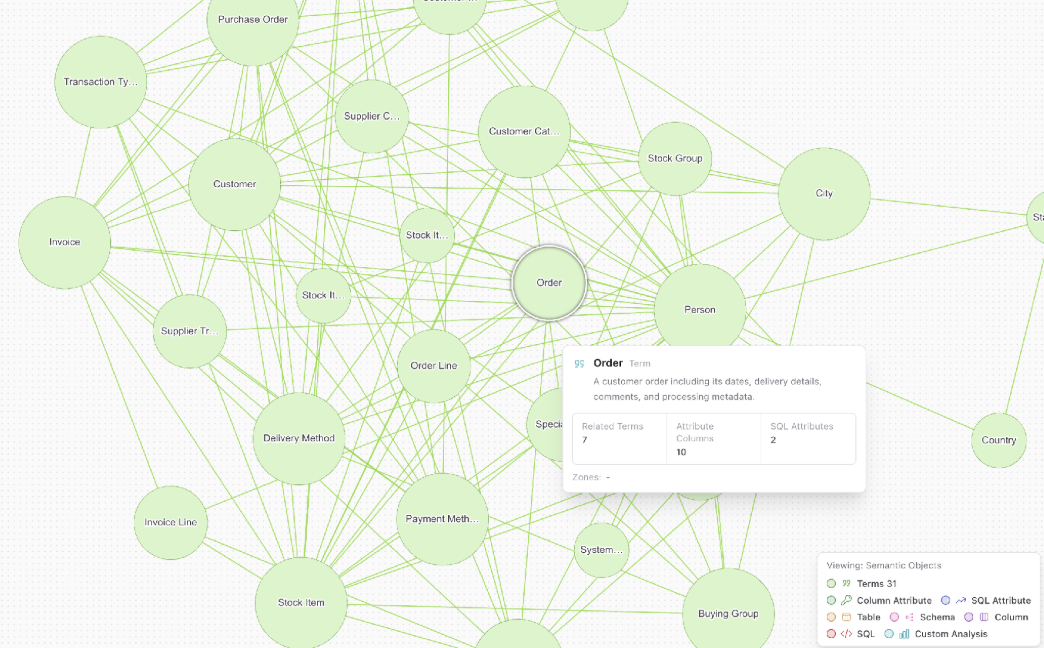
然后是认证:人在聊天界面里用真实问题测试,或走 MCP 的 check_answerable、ask_question,在 UI 或 API 里修正术语、描述和 SQL 属性,确认无误后”认证”。
最后是回答:Agent 先分类意图、抽实体,再按向量检索候选术语、列和 SQL 属性,写出 SQL,执行前校验过滤值和查询本身,跑完返回答案——附 SQL 和推导步骤,能对着源头复核。答不上来的时候它会直说,比如问”广告支出回报率”,而库里根本没有广告数据,它会先检查可回答性,再问你要不要换个问法。
快速上手
需要 Docker(含 Compose v2)、uv 和一个 NVIDIA API key(nvapi-...,去 build.nvidia.com 申请)。克隆仓库、配好 .env、docker compose up 起 Postgres 并导入示例库,再启动其余服务,打开 localhost:3000 登录,在”设置 → 语义编译”里打开编译,就能在聊天框里提问了。默认用的模型是 nvidia/nemotron-3.5-lightning-30b-a3b(LLM)、nvidia/nemotron-3-embed-1b(向量)和 nvidia/llama-nemotron-rerank-vl-1b-v2(重排),也可以换成自托管的 NIM。
组件上分工很清楚:前端 Next.js 16、后端 FastAPI、摄取服务、Postgres + pgvector、认证用 Better Auth、凭证可选 HashiCorp Vault,Kubernetes 有 Helm chart,本地用 Docker Compose 就能跑起来。
要注意什么
- 推理要走 NVIDIA NIM 端点,托管的或自托管的都行,需要 API key;
- README 明确写了目前不接受外部贡献;
- 预测类问题要接 KumoRFM 才支持,需另外配置。
如果你在折腾 Agent 做数据分析,站内这篇《500+ AI Agent 实战项目合集》里有 LangGraph、CrewAI、AutoGen、Agno 的成套例子可以对照着学;想看 Agent 怎么从零复刻一个应用,《Craft Anything》是另一条路子;对视频工作流感兴趣的话,OpenMontage把 AI 编程助手变成了完整视频工作室。
转自 GitHub 作者 NVIDIA 的文章《Auto Ontology》,原文链接:https://github.com/NVIDIA/auto-ontology

暂无评论内容