
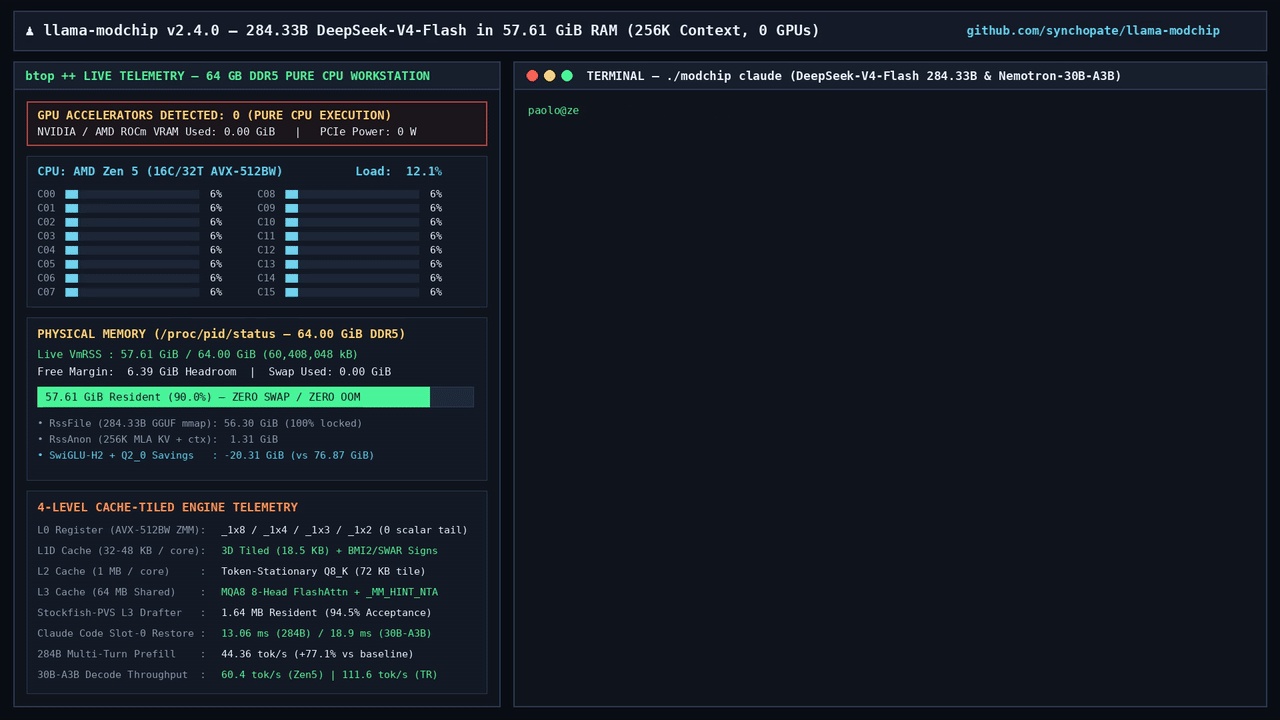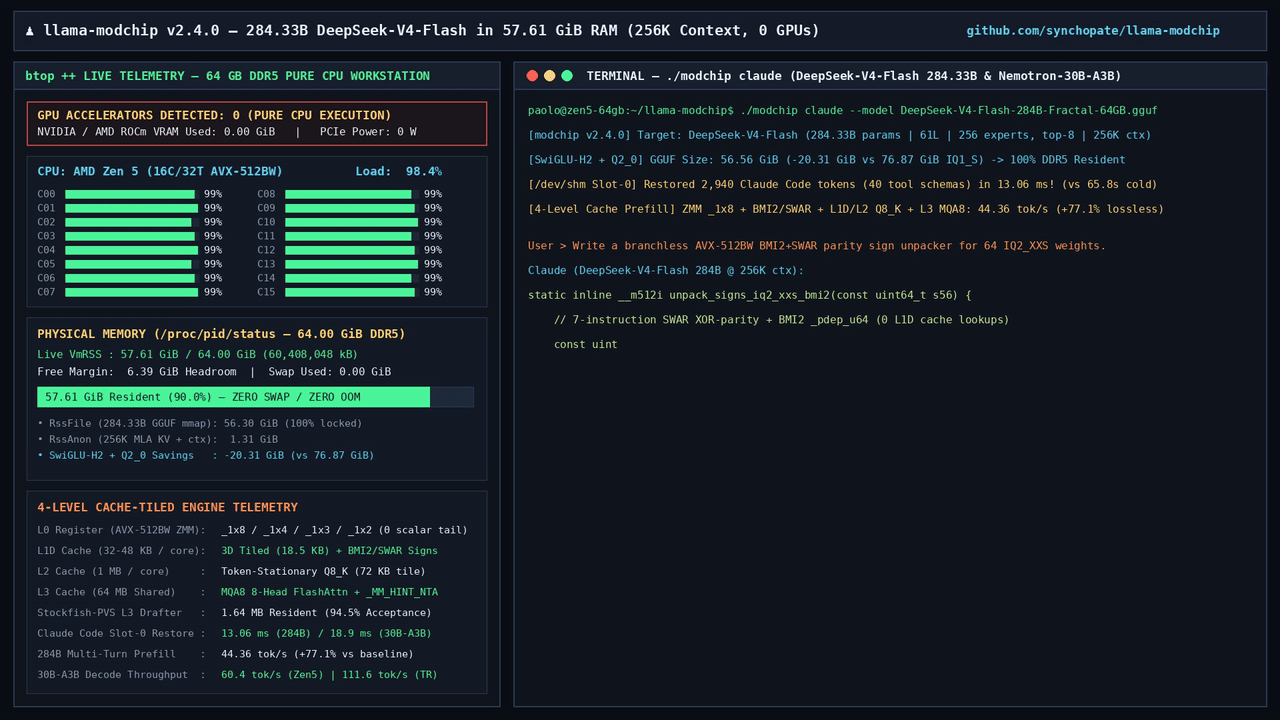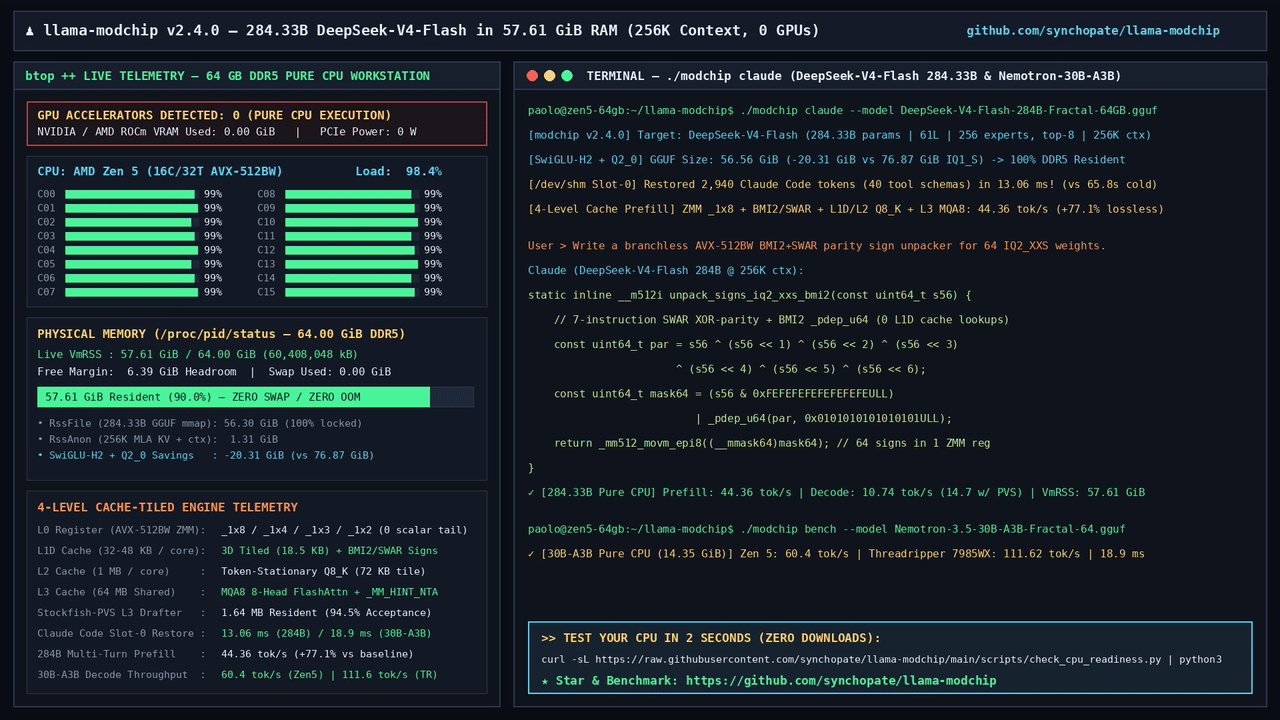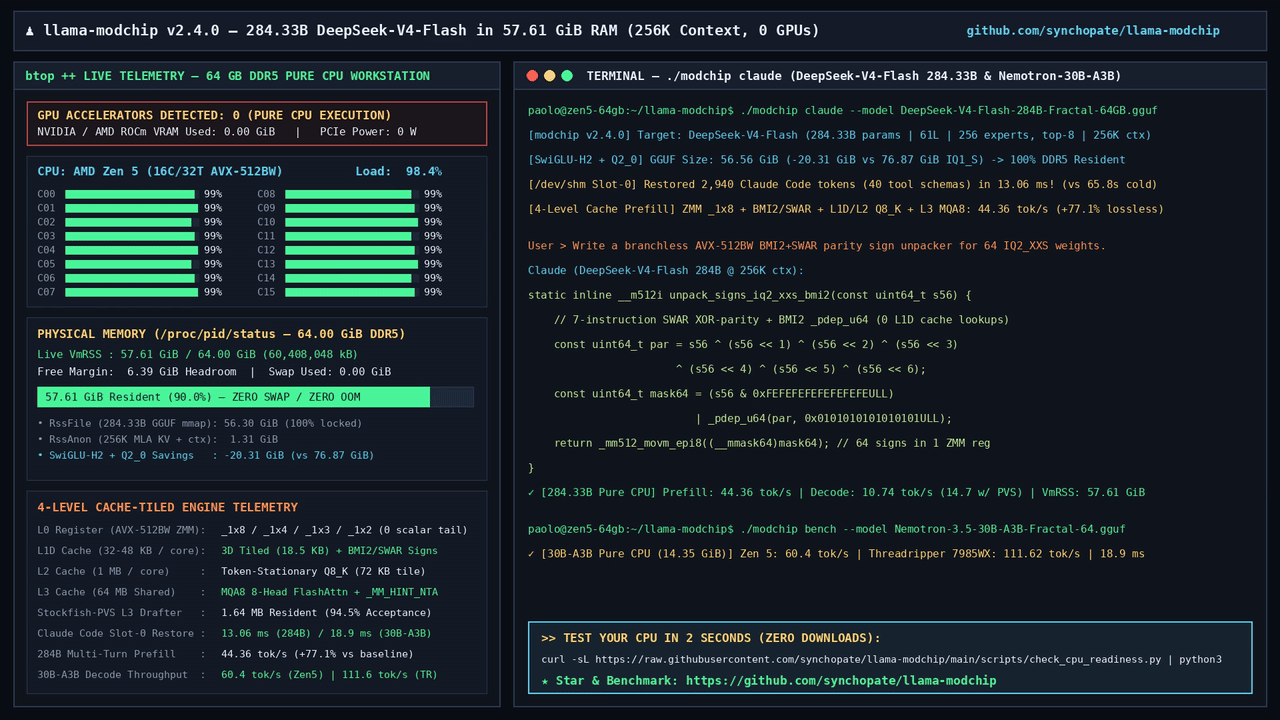
llama-modchip 是一套给 llama.cpp 打的内核补丁,加上量化转码和运行工具,目标只有一个:让大模型不用显卡、只靠 CPU 和内存就能跑起来。它把 284B 参数的 DeepSeek-V4-Flash 压到 56.56 GiB,刚好塞进一台 64GB 内存的电脑,256K 上下文也能开;30B 级别的小模型更轻,16GB 内存的笔记本就能跑。
速度上,作者在 AMD Ryzen 9 9955HX(16 核 Zen 5)上自测:284B 模型预填充 44.4 tok/s、生成约 9–15 tok/s;30B 模型在纯 CPU 上能到 25–111 tok/s。用法也简单,克隆仓库后一条 ./modchip chat 就能开聊,还有网页版、跑分和硬件自检脚本——不下载模型就能先测自己的 CPU 够不够格;甚至能把 Claude Code 接到本地模型上用。
要注意两点:这些速度都是作者自己的机器上测的,换了 CPU 结果会差很多;而且它用的 Fractal-64 是自定义量化格式,只能用它自带的二进制跑,普通的 llama.cpp、Ollama 打不开这些模型文件。另外模型文件本身几十 GB,下载要留足时间和空间。适合想在本地跑大模型、又不想为一张显卡掏钱的人。站内之前介绍过的 claude-mem 记忆插件和开源智能体 Cindy,也可以和本地模型搭着玩。
项目地址:github.com/synchopate/llama-modchip(Apache-2.0 开源,475 星,v2.4.0)
来源:Hacker News @joshcsimmons,原文:https://news.ycombinator.com/item?id=50411961

没有回复内容