
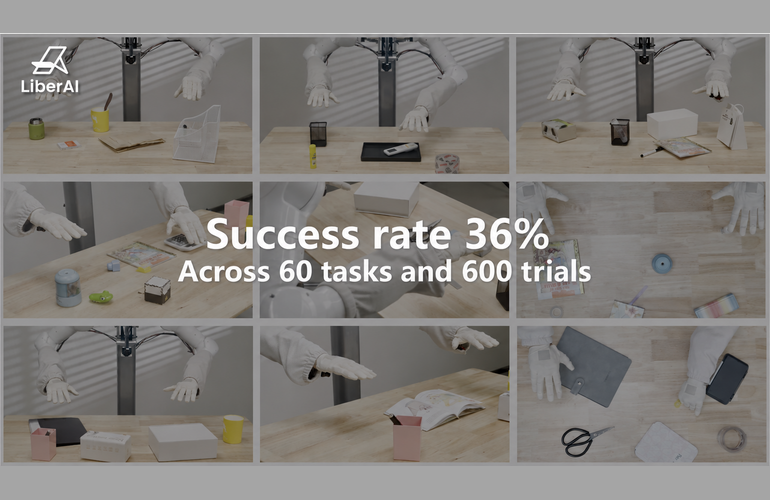
北京初创 LiberAI 11 月 4 日发布 Liber-0:一个“世界动作模型”,用 220 万+小时人类经验预训练,同时预测未来视频帧与动作,把人类操作经验转成机器人技能。在 60 项由 GPT-6 提出的任务、600 次试验里,零样本总体成功率 36.0%:取放类 63.5%、其他操作 34.0%、困难长程任务仅 10.5%。
“零样本”要说清口径:指没有用针对这些目标任务采集的机器人示教数据训练,预训练阶段仍包含机器人数据。技术路径有三条:LiberSense 手套直接记录手部姿态与轨迹、把人类视频与真实动作对应;LEO 机器人平台的相机视角与手腕/腰部结构向人类对齐;统一具身表征适配不同身体形态。
两组对照实验值得看:只用机器人数据训练时,非取放任务进度分 2.2,加入手套数据后升到 47.5(再加取放手套数据为 54.6),接近全机器人示教的 56.3;另一组用 25% 机器人数据 + 全部手套数据得 75.6 分,超过 100% 机器人数据的 72.8 分。官方还做了互动模拟 sim.liberai.work,可上传自己的物体看 Liber-0 在虚拟环境里操作。
局限官方也自述了:手套目前只记录手部姿态与轨迹,不记录接触力/触觉;内部基准上预训练检查点取放进度分 81.4、非取放 72.3,机器人后训练仅各加 2.2 与 1.5 分。注意:以上数字全部是 LiberAI 官方口径,未见第三方复现;The Robot Report 这篇报道也标注为 LiberAI 赞助内容。
同样是让模型动手操作,腾讯的 Hy4 首次会看图、能操作电脑。
来源:The Robot Report @The Robot Report,原文:https://www.therobotreport.com/liberai-unveils-liber-0-a-world-action-model-that-grounds-human-experience-in-robot-action/

没有回复内容