
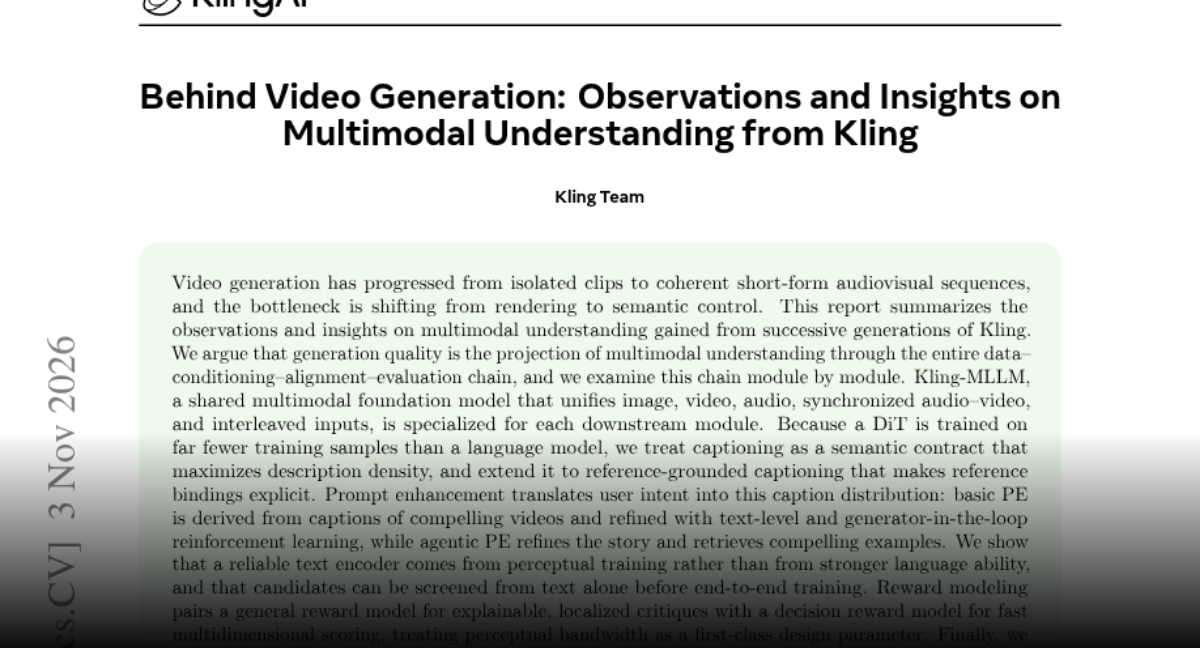
快手 Kling 团队 11 月 3 日发表论文《Behind Video Generation》,登上 Hugging Face 当日论文第 2。它不讲怎么渲染更好看,讲的是另一件事:视频生成的瓶颈已经从渲染转向语义控制,生成质量是多模态理解在“数据—条件—对齐—评估”整条链上的投影。
论文的核心观点有这么几条:
- 理解先行:Kling-MLLM 是一个共享的多模态基础模型,统一处理图像、视频、音频、音画同步和图文交错输入,再针对每个下游模块做专门化。
- Caption 是语义契约:因为 DiT 的训练样本比语言模型少得多,caption 要尽可能提高描述密度,还要做 reference-grounded captioning,把指代关系写明确。
- 提示词增强:基础的提示词增强来自好视频的 caption,再用文本级和生成器在环的强化学习打磨;智能体式的提示词增强则负责打磨故事、检索好例子。
- 文本编码器靠感知训练:一个可靠的文本编码器来自感知训练,而不是更强的语言能力;候选可以在端到端训练之前只用文本筛一遍。
- 奖励建模:通用奖励模型给可解释的、局部的评价,决策奖励模型做快速多维打分,感知带宽是头等设计参数。
- 自动评估:重点是能暴露评分捷径、把失败追溯到上游源头的评估协议。
一句话:想做好可控的视频生成,先把理解这一层搭扎实。论文全文见 arXiv 2611.04916,Hugging Face 论文页也有摘要和引用。
相关阅读:AI视频正式进入3.0时代。
来源:Hugging Face Papers,原文:https://huggingface.co/papers/2611.04916

没有回复内容