
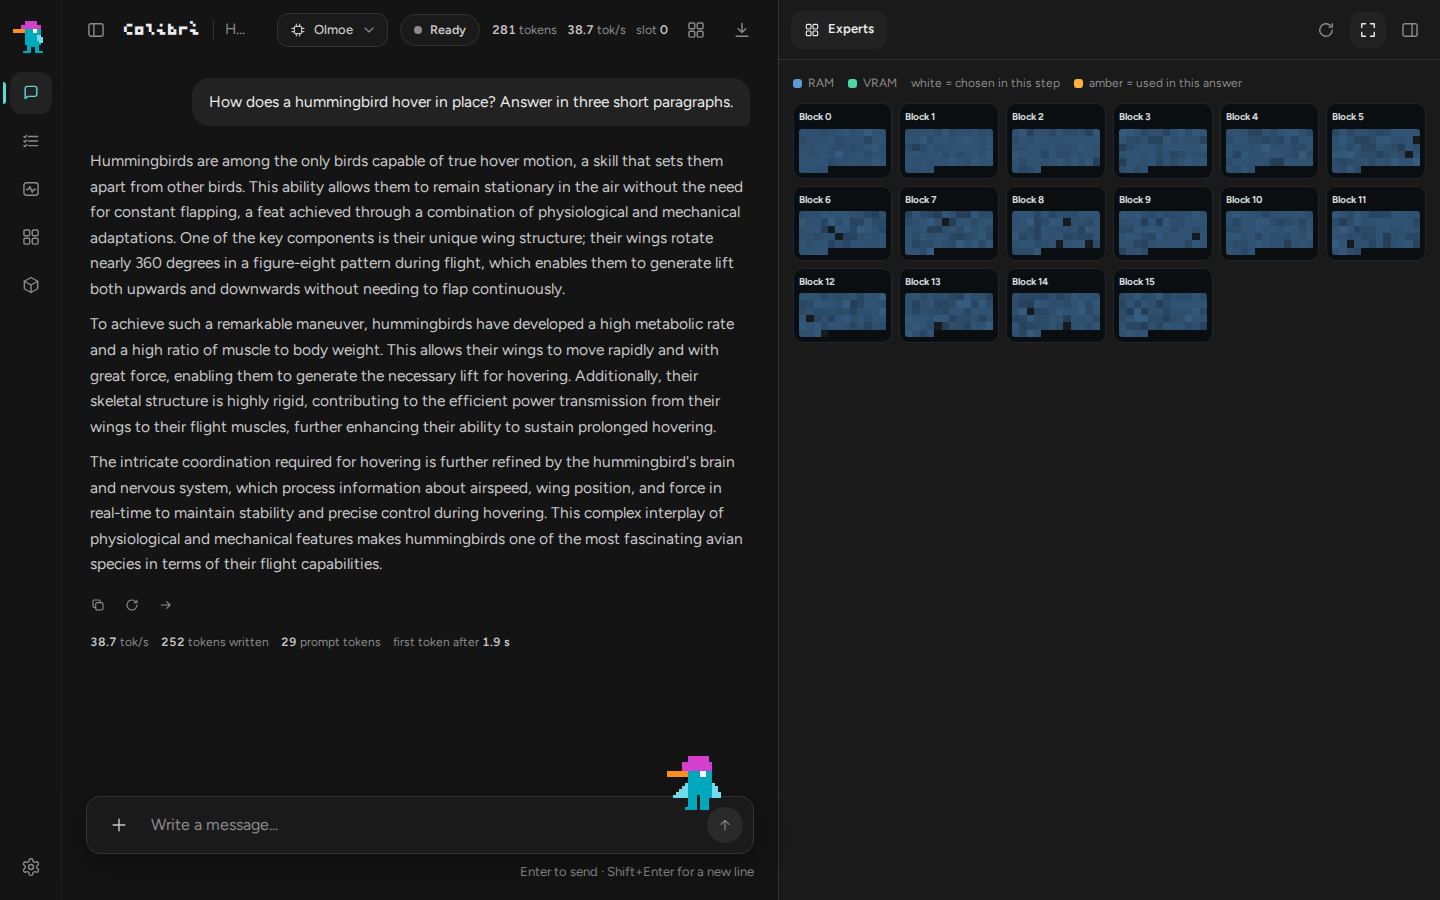
colibri 是一个纯 C、零依赖的开源大模型推理引擎,专门用来在自家电脑上跑超大 MoE(混合专家)模型。它的思路很直接:模型每生成一个 token 只用到一小部分参数,那就只把公共部分常驻内存,被选中的专家按需从硬盘读进来。拿 GLM-5.2 来说,744B 参数的模型,每 token 实际只激活约 40B 参数,官方示例里常驻内存不到 10GB,32 秒就能就绪开聊。
10 月 31 日发布的 v2.1.0 是个大版本:387 个 PR,GGUF 文件现在所有引擎都能直接读、不用转格式;新接了 Mistral-Large-4(1T)、Muse Spark Open、Flint、DeepSeek V4.1 Flash 和 Kimi K3;新聊天界面 coli ui 能实时看到各个专家被调用的情况;Qwen3.8-Flash-Next 的 256k 上下文跑出了 64k 上下文的速度。支持的模型已有 13 个引擎,覆盖 GLM、DeepSeek、Qwen、Kimi、MiMo 等,另有文生图(Qwen-Image-2.1)和决策模型。
Mac 上装起来也不麻烦:Homebrew 装好依赖,git clone 后 ./start-here.sh,一步完成检测、选模型、下载和启动,Apple Silicon 有 Metal 构建。最低只要 8GB 内存、22GB 空闲硬盘就能起步,跑起来后还提供 OpenAI 兼容接口(http://127.0.0.1:8000/v1),可以让其他工具直接连它。不过要提醒一句:几百 B 的大模型在纯 CPU 上很慢(官方数据里 DeepSeek V4 Flash 纯 CPU 约 1 token/秒),日常用更实际的是 Qwen3.6-35B 这类小模型,CPU 上约 6 token/秒。4.6 万星,Apache 2.0 开源。
站内相关:FreeToken:把 290B+ 的开源大模型搬到你自己的电脑上跑、Nace 开源 27B 决策模型 Drex Max v1:24GB 内存的 Mac 就能本地跑。
来源:GitHub @JustVugg,原文:https://github.com/JustVugg/colibri

没有回复内容