
MediaCrawler 是一个开源的多平台自媒体数据采集工具,支持小红书、抖音、快手、B站、微博、贴吧、知乎等主流平台的公开信息抓取:关键词搜索、指定帖子 ID、二级评论、指定创作者主页、登录态缓存、IP 代理池,还能生成评论词云图。
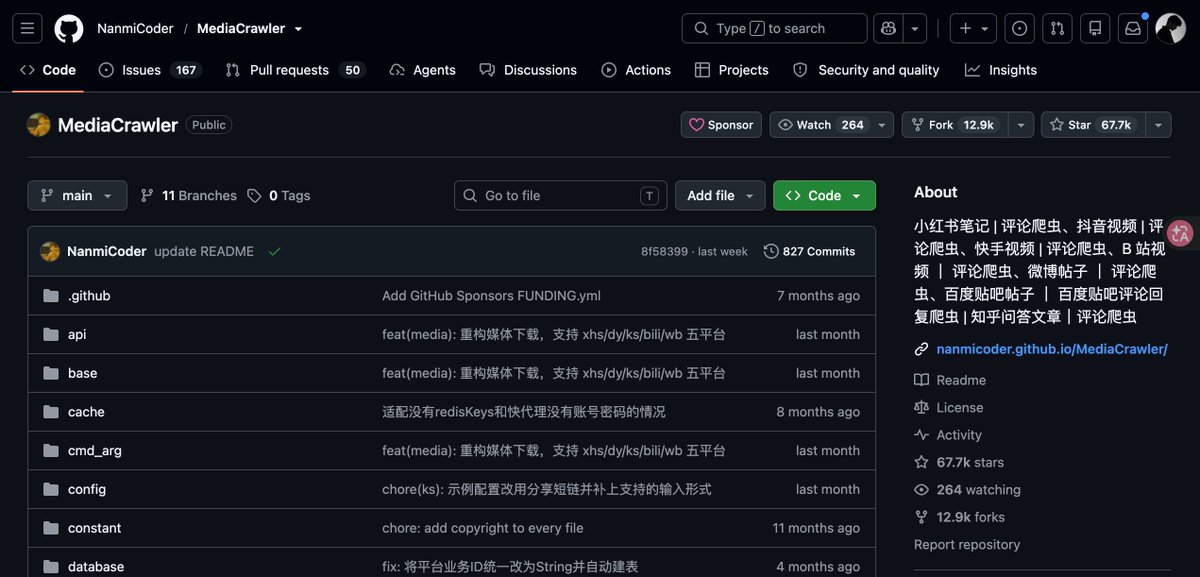
技术路线是基于 Playwright 浏览器自动化,复用登录态的浏览器上下文、用 JS 表达式获取签名参数,不用去逆向复杂的加密算法,门槛相对低一些;默认可用 CDP 模式连接已有的 Chrome 浏览器,还有 WebUI 可视化界面。数据可存为 CSV、JSON、JSONL、Excel、SQLite 和 MySQL。
项目地址:GitHub NanmiCoder/MediaCrawler,目前约 6.8 万星。提醒一句:作者在仓库里明确写了仅供学习和参考、禁止商业用途,使用时也要遵守平台规则和法律法规,不要拿去大规模爬取或做违规用途。
来源:X @溺心海·Aven,原文:https://x.com/NIxinhai0/status/2113661348471292252


没有回复内容