
除了 3D,Kimi K3.1 Pro 今天流出的另一组案例更说明它的长程任务能力:不是答一道题,而是在几十上百轮执行里自己发现问题、改策略、再跑通。
官方最典型的例子是人体行走动力学仿真:基于 296 个骨骼组件、402 个肌肉组件的开源人体解剖模型,模型在 167 项任务、420 次独立评审里反复调整行走控制器,让原本几秒就倒的虚拟人连续走了 11.2 秒。关键一步是,当调奖励怎么都改善不了手臂动作时,它转去检查仿真器本身,定位并修正了肩部肌肉力臂计算里的 36 处错误,再重新训练。
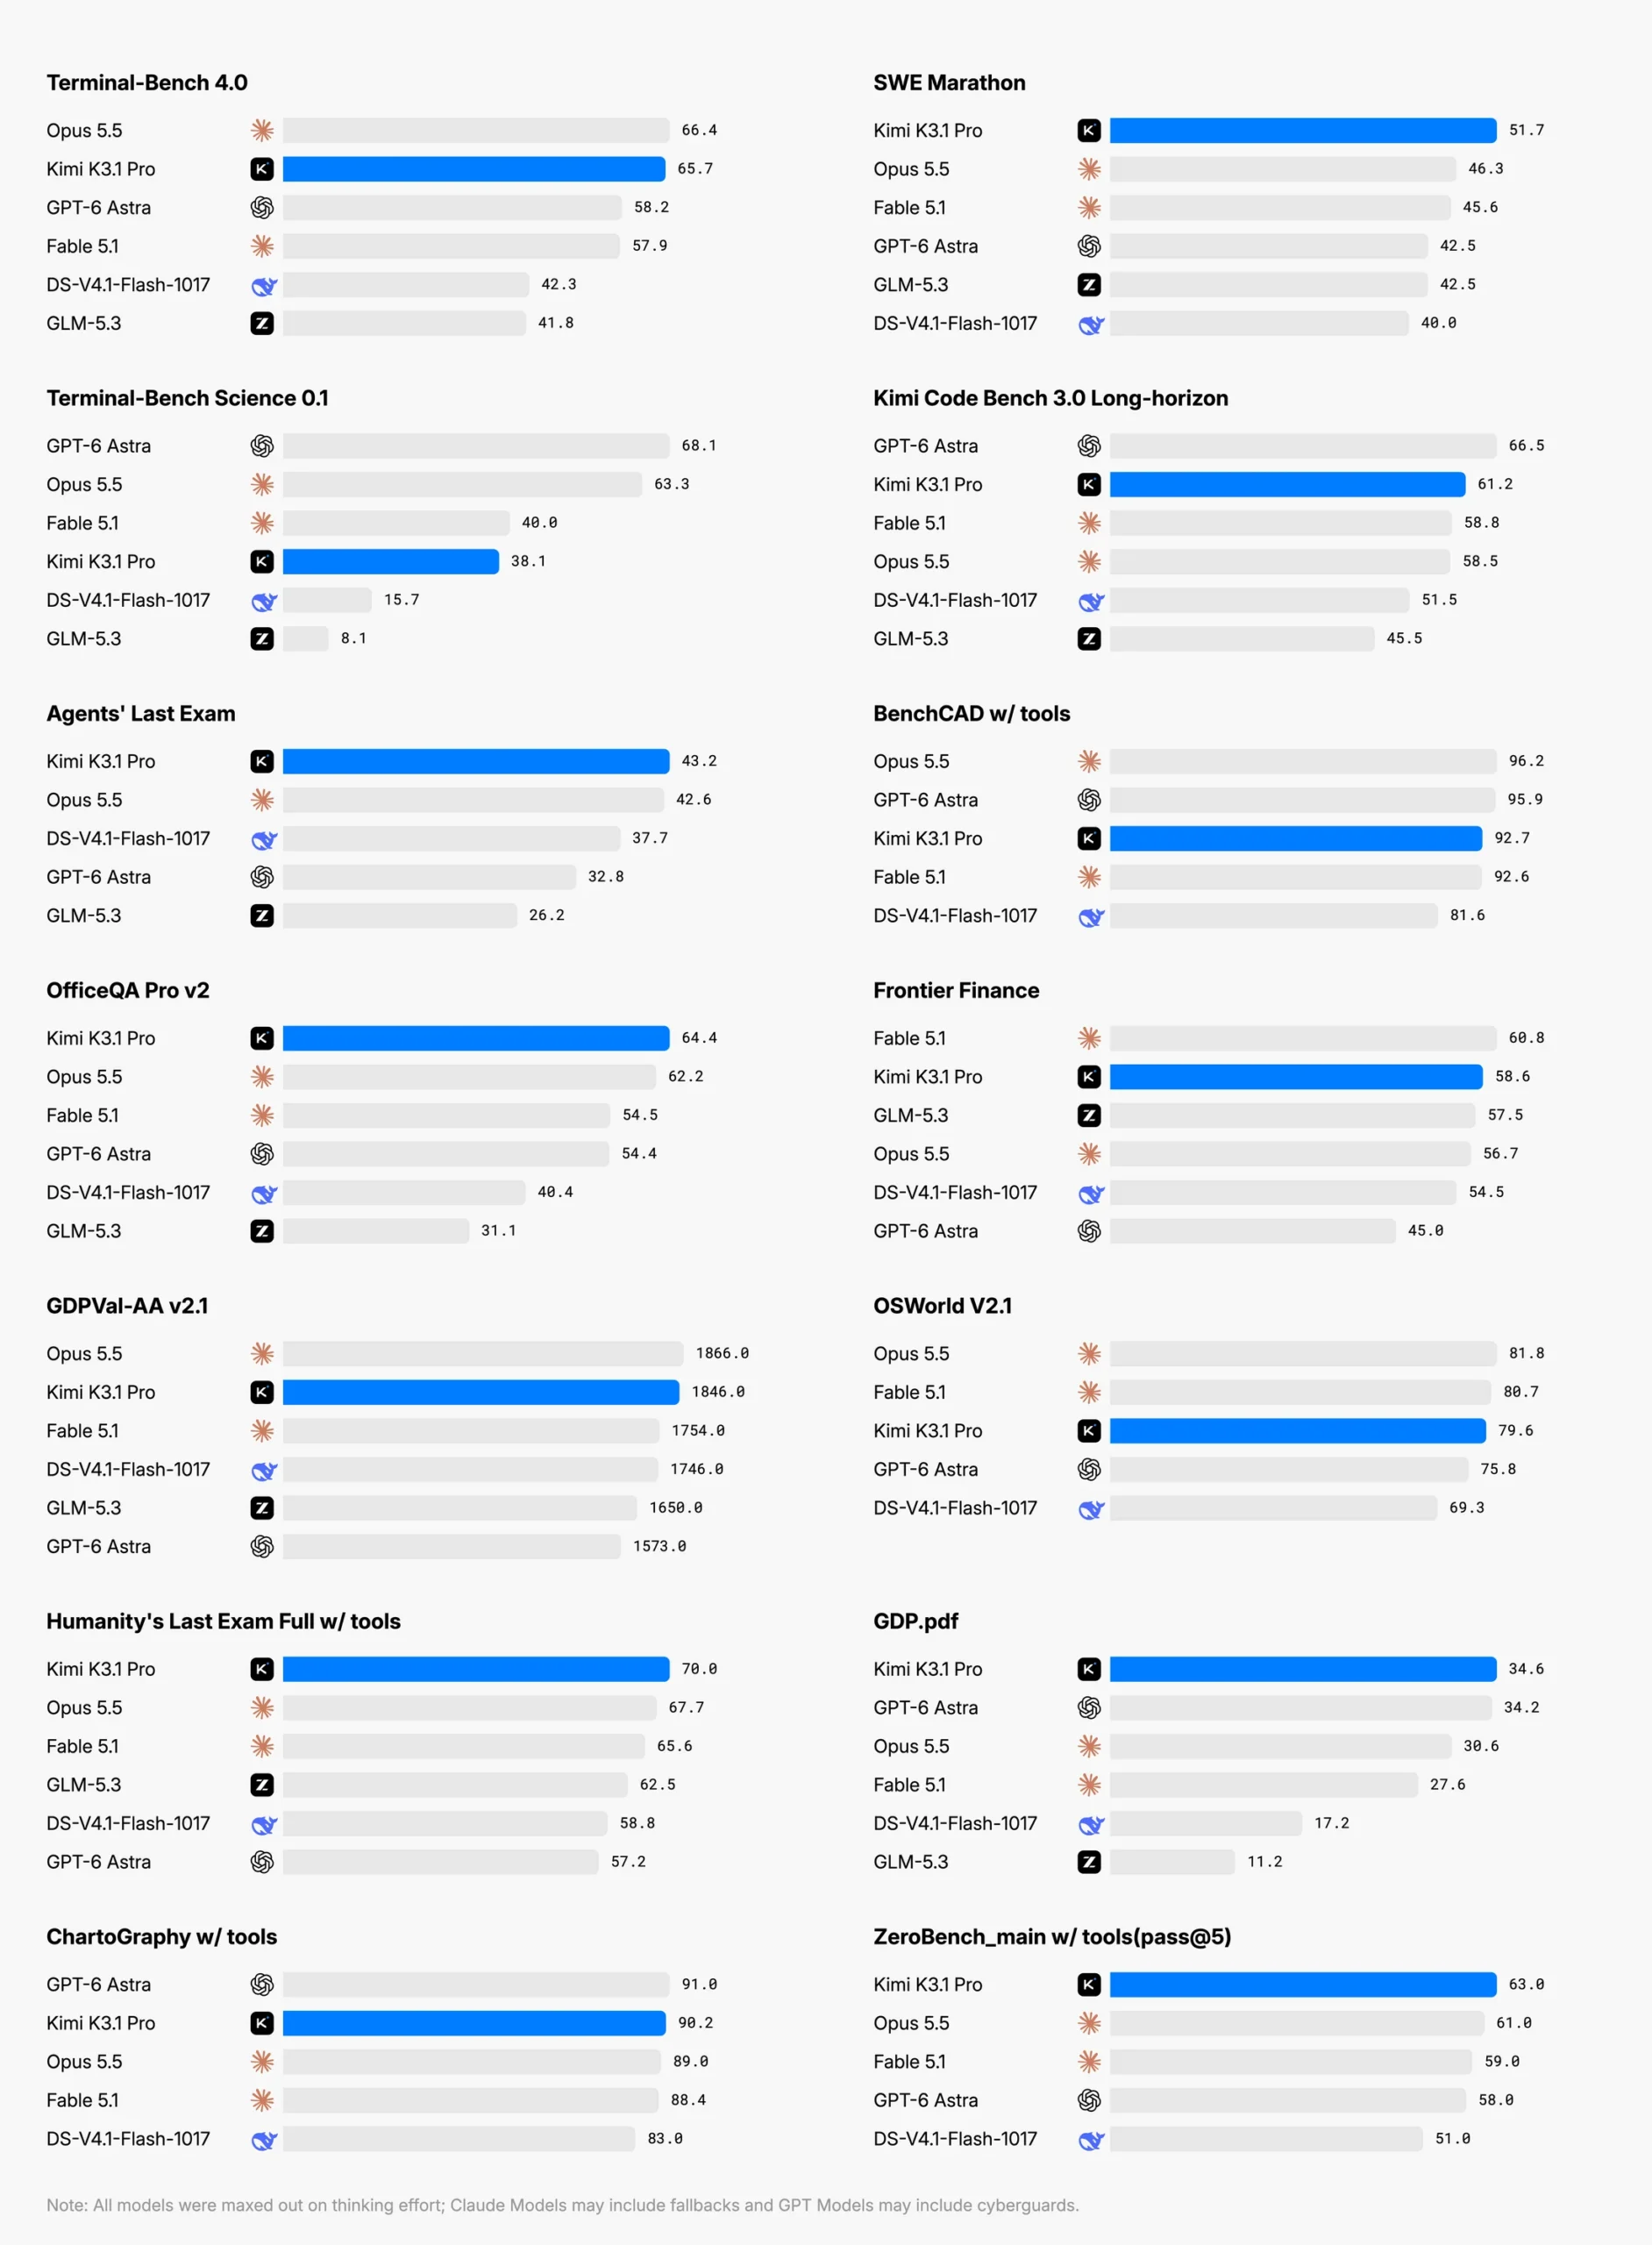
金融方向同样强调“交付能接着用的文件”:官方案例包括可调经营假设的英伟达财务模型 Excel,以及围绕业绩、预期差和催化因素展开的宁德时代投资分析 PPT。内部基准上,金融建模比 K3 提高 7.2 分、金融研究提高 11.6 分,OfficeQA Pro v2 拿到 64.4 分。智东西的实测也类似:把 SpaceX 最新财季 10-Q 财报甩给它,约 2 分钟就从密密麻麻的表格里找出关键数据生成桑基图,人工抽检后数据与财报一致,指出字号问题后也很快改好。
还有一个很实用的对照:Atomic Agent 团队出的小型 Python 任务(修 5 个 Bug、补结算函数和命令行工具),K3.1 Pro 的低档和最高档在各跑 3 遍、32 项隐藏测试验收下都全过,但低档平均 2.2 分钟、单次约 0.16–0.21 美元,最高档 4.9 分钟、约 0.35–0.46 美元。也就是说,任务明确时把思考拉满未必多做对,反而更贵更慢,档位值得按任务挑。
背景可看站里今早的 Kimi K3.1 Pro 正式发布:2.8 万亿参数、代码 Agent 能力接近 Claude Opus 5.5,开源权重 11 月 4 日放出。
来源:月之暗面官方博客,原文:https://www.kimi.ai/blog/kimi-k3-1-pro


没有回复内容