

炸了!RTX 40 系显卡算力被破解了,性能近乎翻倍!从 4090 到 4060 Ti 全都能用。
不刷 BIOS、不改驱动,直接把被锁的 Tensor 算力放出来,跑 AI 矩阵乘快一倍左右。
实测亮点
- 4090:FP16 / BF16 从 165 → 331 TFLOPS,接近翻倍
- 4080 SUPER:FP16 涨到 1.83 倍,FP8 也翻倍
- 4070 Ti SUPER:FP16 / BF16 翻倍,FP8 矩阵乘涨到 1.95 倍
- 4060 Ti:还能涨近 40%,Windows 也能试
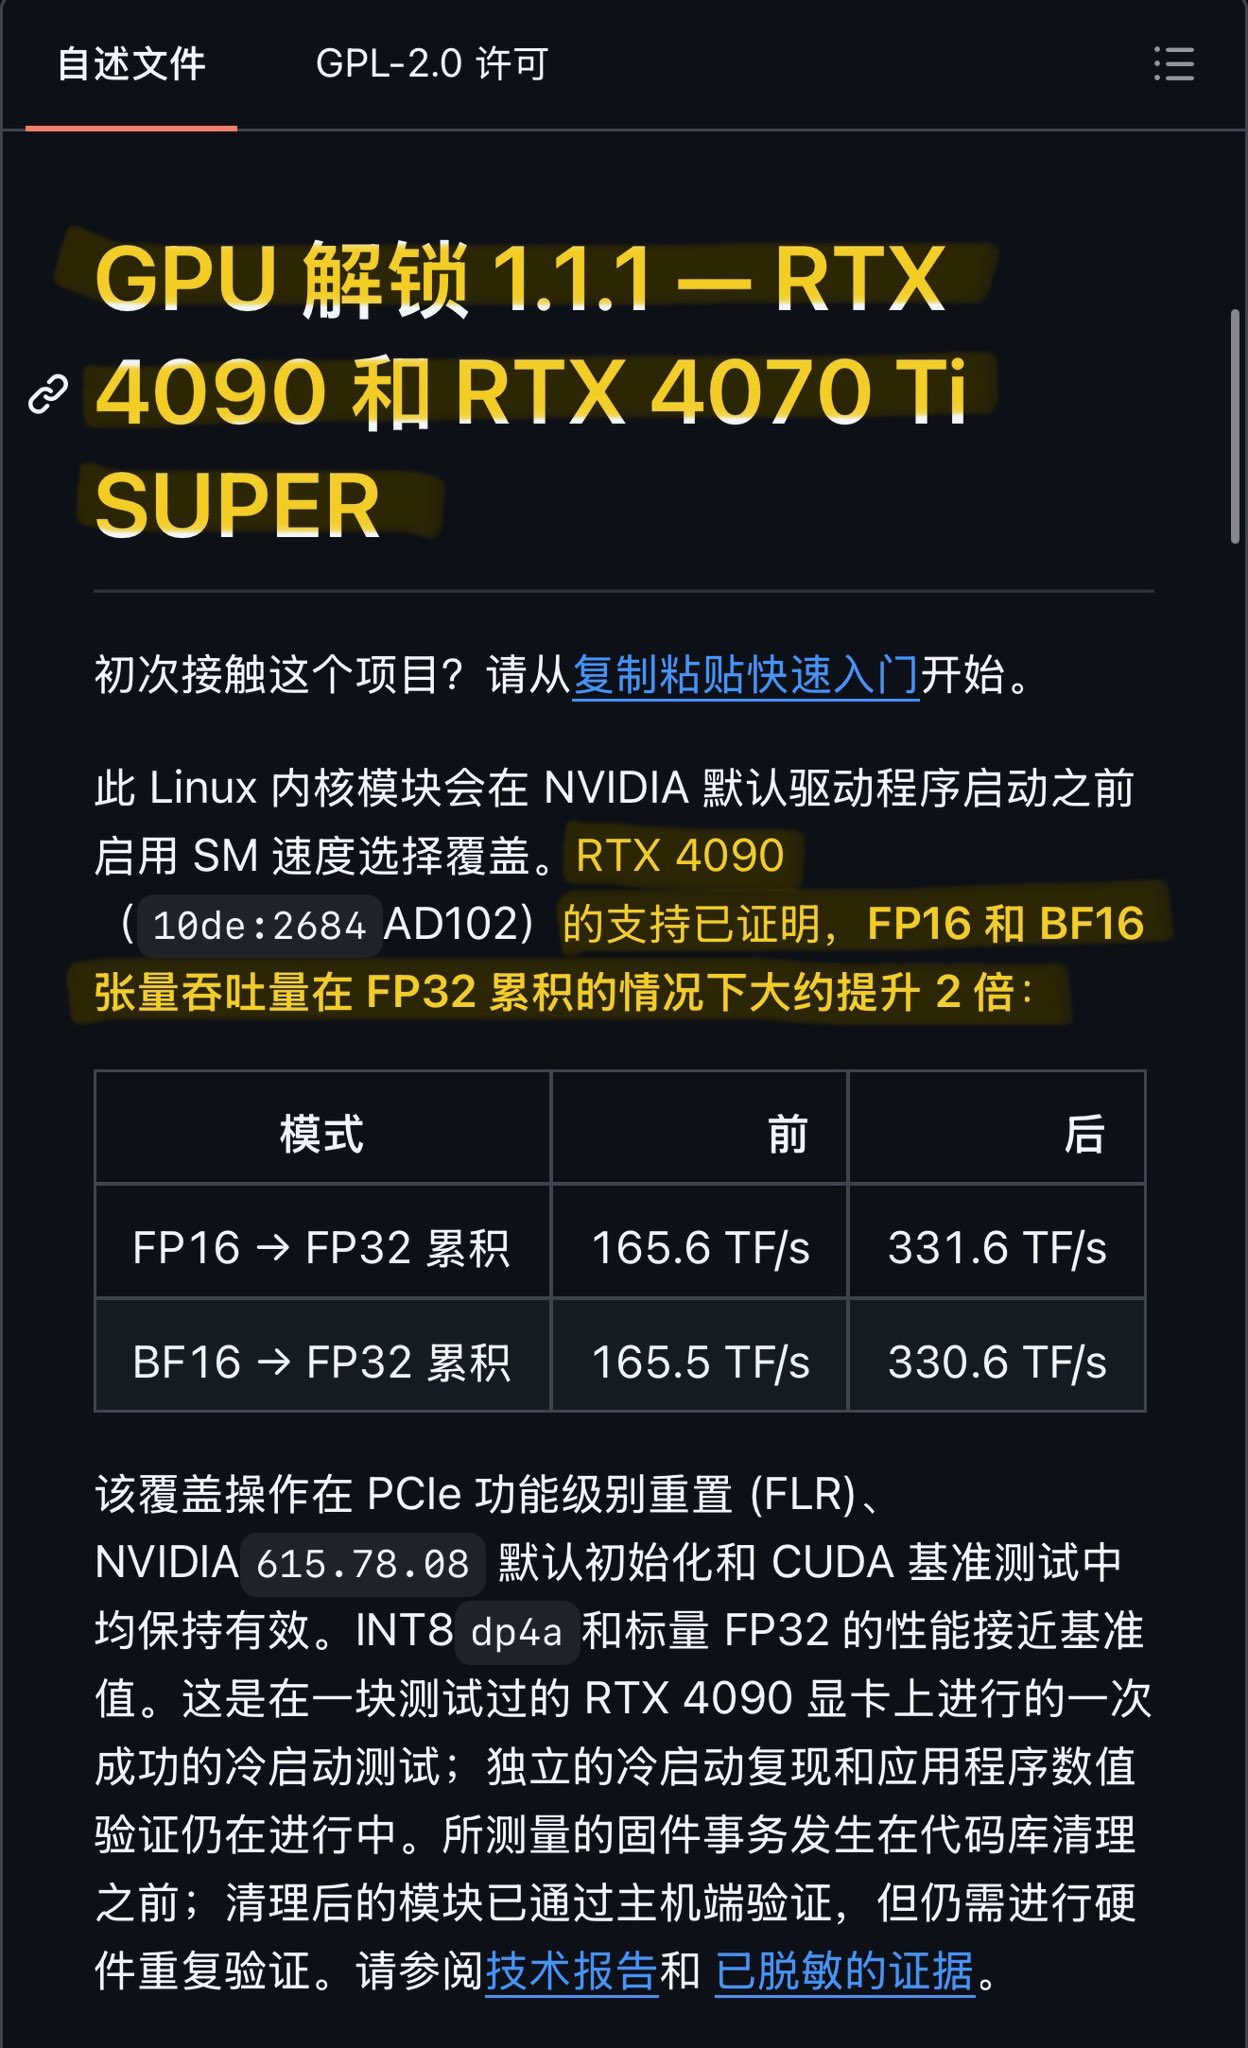
图:项目 README 里的实测表,4090 FP16→FP32 累积从 165.6 涨到 331.6 TF/s,BF16→FP32 累积从 165.5 涨到 330.6 TF/s。来源:gpu-unlock-ada README
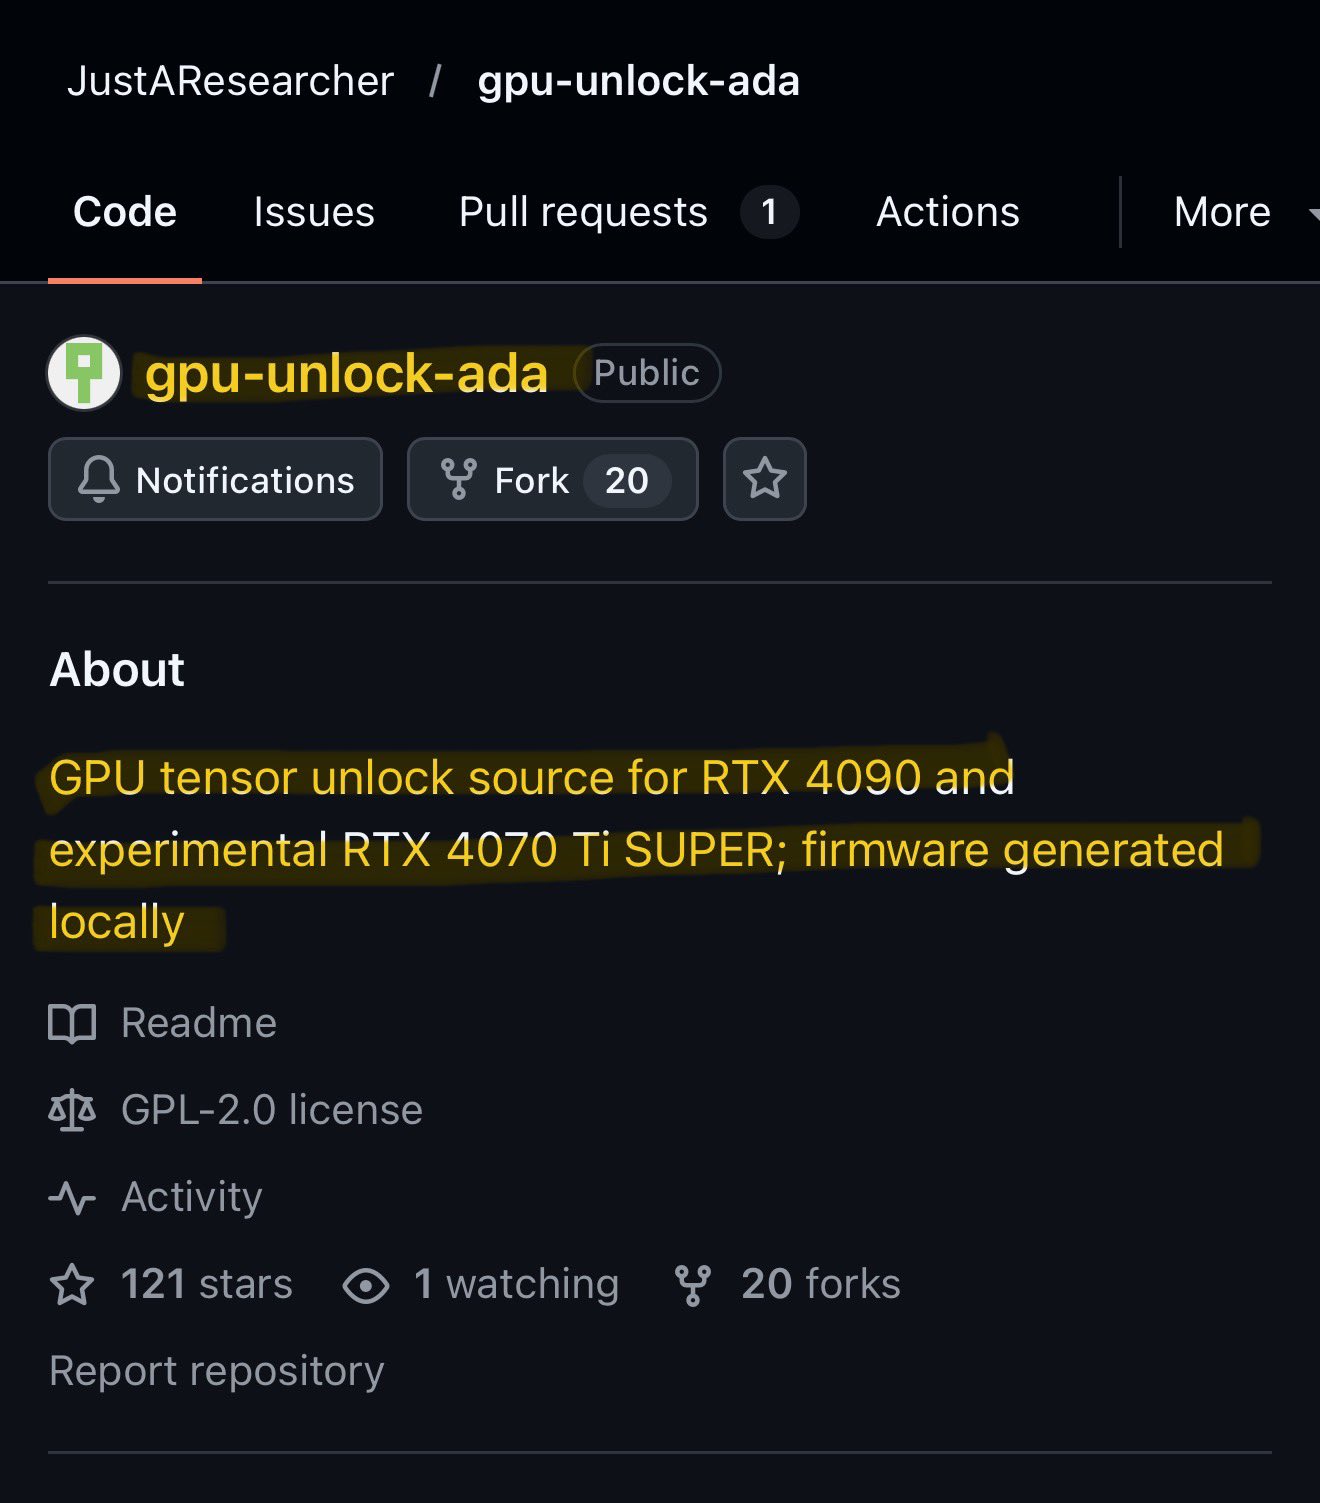
图:GitHub 上的 gpu-unlock-ada 仓库,面向 RTX 4090 与实验性 RTX 4070 Ti SUPER,GPL-2.0 协议。来源:GitHub
简单使用步骤(Linux)
- 下载安装:
git clone https://github.com/JustAResearcher/gpu-unlock-ada.git && cd gpu-unlock-ada && make install - 运行
python3 tools/print_boot_option.py拿到你的卡参数 - 把参数加到开机启动项,关掉 Secure Boot
- 关机、拔电源等几秒再开机(必须冷启动)
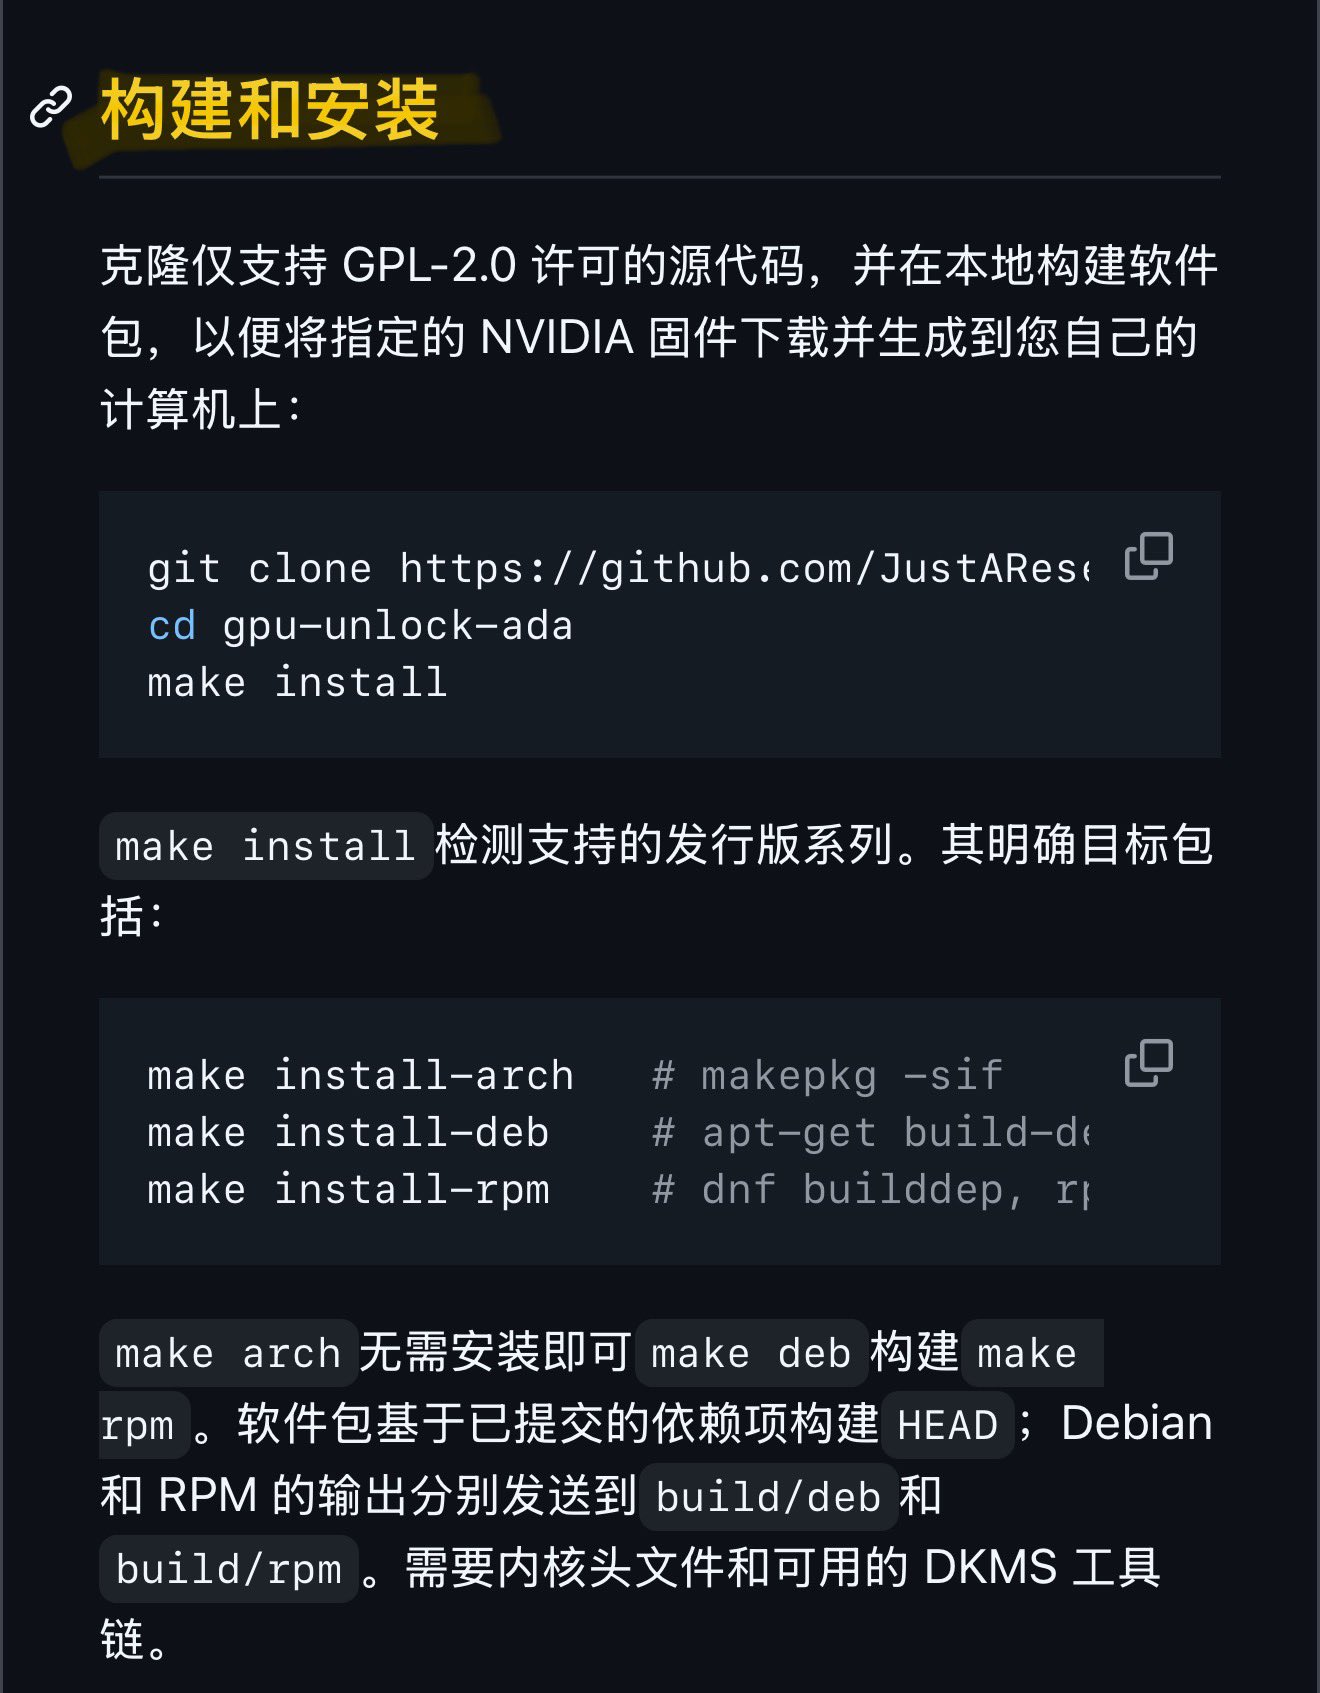
图:构建安装说明,源码在本地构建,make install 安装,另有 arch / deb / rpm 安装目标,需要内核头文件和 DKMS 工具链。来源:gpu-unlock-ada README
Windows 用户去搜:Hugging Face:TOTORONG / AD103_win_unlocker。
仓库:GitHub:JustAResearcher / gpu-unlock-ada。敢试的今晚拔电源试试,评论区报结果!
背景一笔:这并不是第一次有人动这块蛋糕。此前 30 系的解锁项目(Zagitta / gpu-unlock)就放出过 3090 Ti BF16 从 87.5 涨到 157 TFLOPS 的数据,vLLM 长上下文 prefill 还能快 33-36%。40 系这次算是把同一套路延续了下来。本地 AI 这条线最近动静不小,昨天站里刚发过 12GB 显卡跑 763B 大模型的 GSQ-RCO 量化版,硬件解锁加上模型量化,消费级硬件的本地 AI 正在越走越宽。
© 版权声明
THE END


暂无评论内容